1. 9월 24일에 바뀐 것과 바뀌지 않은 것
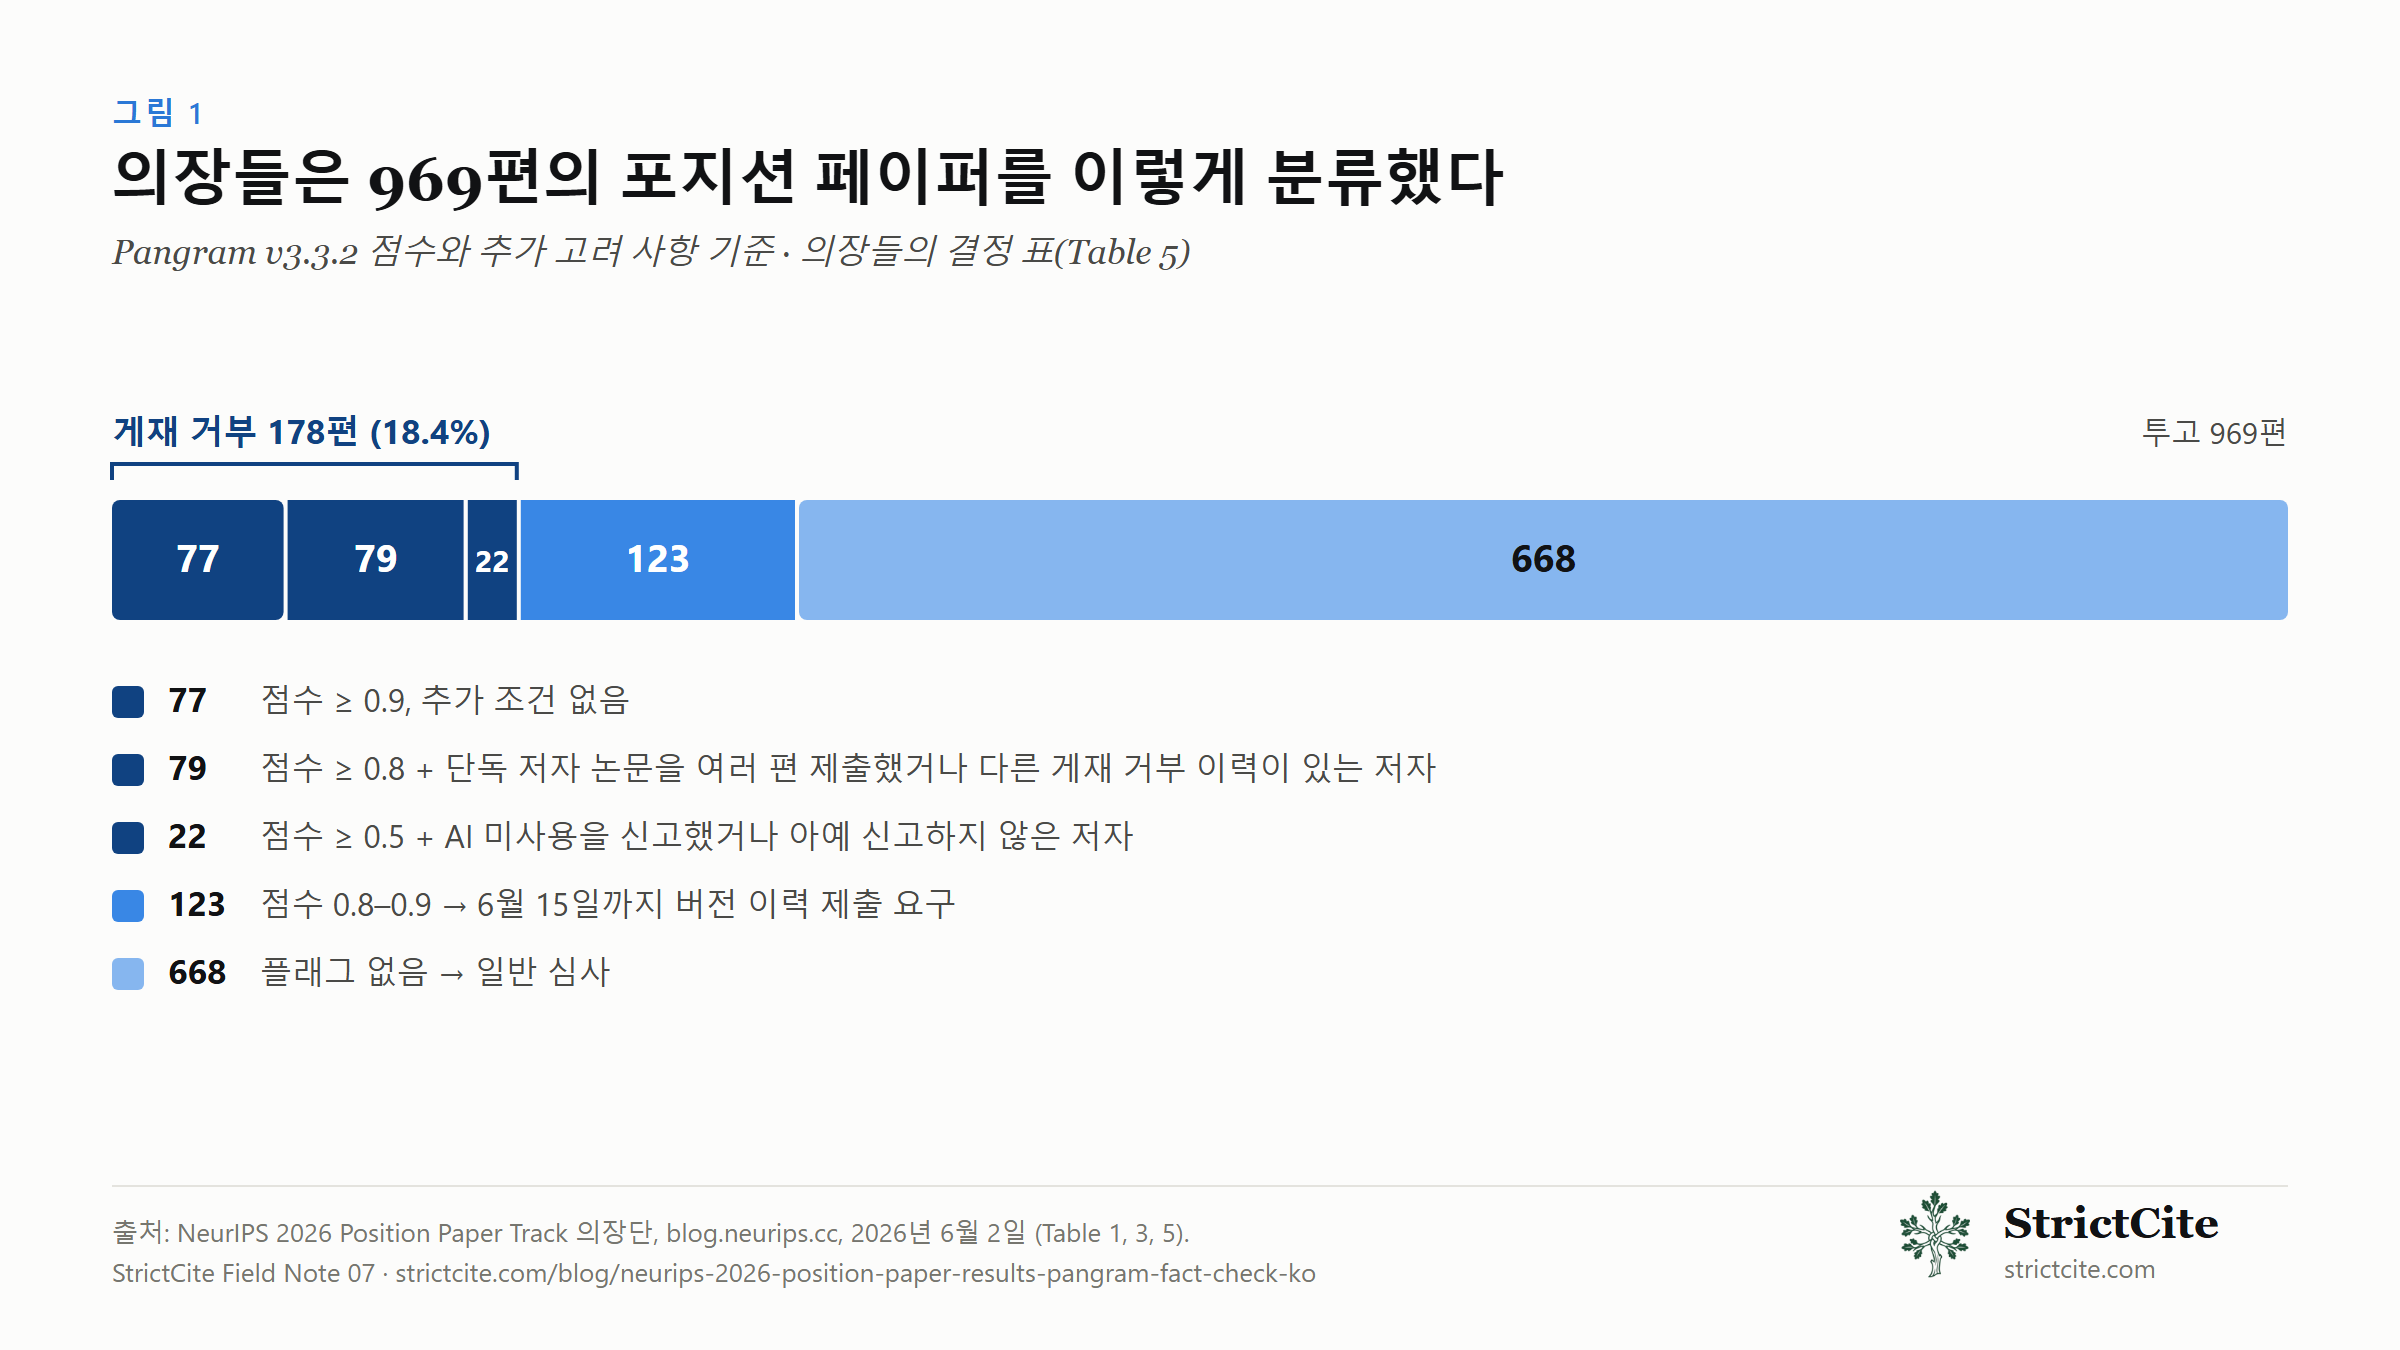
Position Paper Track의 논문 모집 공고는 9월 24일을 최종 결정일로 명시한다[2]. 트랙에 남아 있던 투고들이 채택 여부를 통보받은 날이다. 조건부로 분류된 123편의 마감일은 아니다. 그 저자들은 6월 15일까지 버전 이력 자료를 제출해야 했고, 그러지 않으면 게재 거부되었다[1].
바뀌지 않은 것은 공개 기록이다. 9월 26일 현재 NeurIPS 블로그의 최신 글은 어피니티 행사(9월 25일)와 재정 지원(9월 16일)에 관한 것이다[3]. 의장들의 6월 2일 글에는 추가 공지가 없다. 123건의 제출 자료 중 몇 건이 인정되었는지, 몇 명이 철회했는지, 트랙이 최종적으로 몇 편을 채택했는지는 어디에도 공개되지 않았다. 이에 대한 숫자를 본다면 그것은 NeurIPS에서 나온 것이 아니며, 우리는 출처가 있는 숫자를 찾지 못했다.
2. 열두 가지 주장, 하나씩 검증
결정일 전후의 글과 요약에서, 그리고 우리의 이전 글에서도 가장 자주 반복된 주장들이다. 각 판정은 같은 행에 링크된 출처에 근거한다.
| 주장 | 1차 출처의 내용 | 판정 |
|---|---|---|
| 9월 24일은 조건부 123편의 최종 게재 거부일이었다. | 증빙 마감은 6월 15일이었다[1]. 9월 24일은 트랙 전체의 최종 결정일이다[2]. | 틀림 |
| 한 번의 커밋에 큰 텍스트 덩어리가 들어갔거나 Grammarly·DeepL 사용을 밝힌 경우 이의가 기각되었다. | 출처를 찾지 못했다. 제출 자료는 “PPT 팀이 검토”하며[1] 결과는 공개되지 않았다. 별도로, 통제된 실험에서 Grammarly 교정은 Pangram의 “AI” 판정을 100건 중 0건 받았다[5]. | 확인 불가 |
| 79편은 점수 0.8 초과 + 단독 저자라는 이유로 거부되었다. | 기준은 점수 ≥0.8에 더해 “단독 저자 논문을 여러 편 제출했고 그중 하나 이상이 기준을 넘는” 저자, 또는 “다른 게재 거부가 하나 이상 있는” 저자다[1]. 단독 저자라는 사실만으로는 해당되지 않는다. | 틀림 (우리도 그렇게 썼다) |
| 22편은 저자가 AI 사용을 부인했는데 점수가 0.5를 넘어 거부되었다. | 기준은 점수 ≥0.5이면서 “저자가 AI를 사용하지 않았다고 신고했거나, AI 사용을 신고하지 않은” 경우다[1]. 신고란을 비워 둔 저자도 포함된다. | 불완전 (우리도 그렇게 썼다) |
| 178건의 게재 거부에는 이의제기가 없었다. | “통상적인 경우 이의제기 대상이 아닌 통상적인 게재 거부”[1]. 123건은 “Desk Reject with Appeal”로 분류되어 있다. | 사실, 단서 있음 |
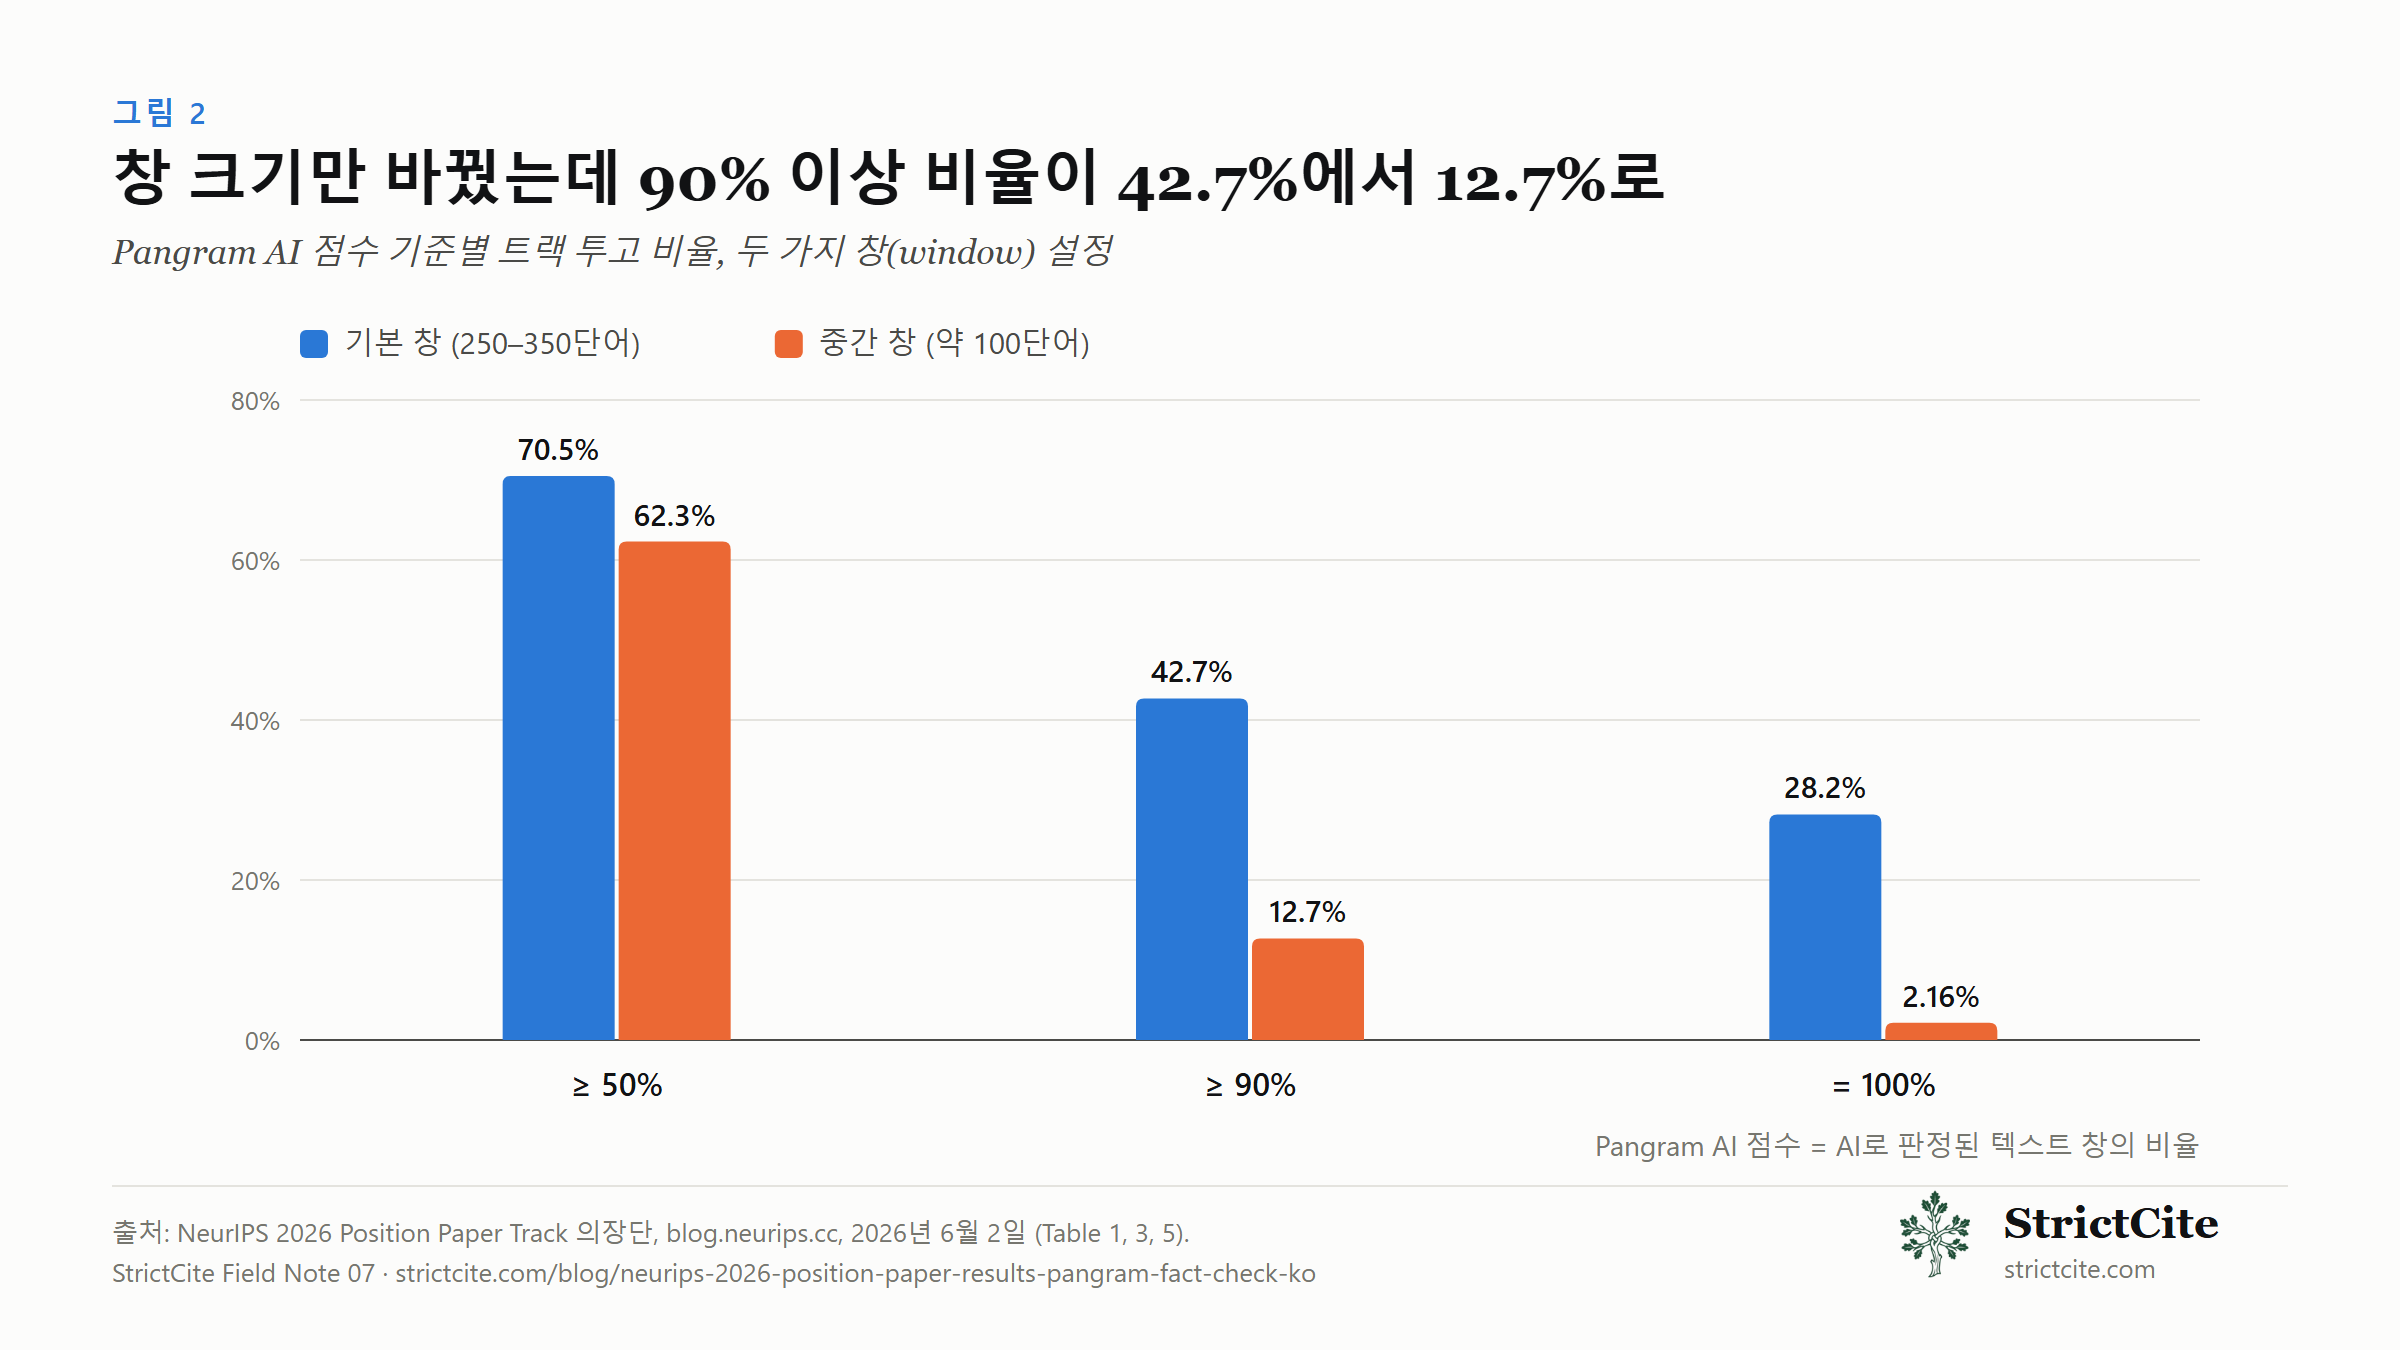
| 기본 250–350단어 창에서 투고의 42.7%가 90–100% AI 점수를 받았다. | 의장들의 글 Table 1과 Table 3: ≥90%가 42.7%, 100%가 28.2%, ≥50%가 70.5%[1]. | 사실 |
| 의장들은 플래그 비율을 낮추려고 창을 100단어로 줄였다. | 숫자는 맞다. ≥90% 비율이 42.7%에서 12.7%로 떨어졌다. 그러나 동기는 의장들이 밝힌 것과 다르다. 그들은 작은 창이 “AI 사용의 과대 판정”을 줄인다고 했고, 그 대가로 줄어드는 재현율(recall)도 공개했다(Table 2)[1]. | 숫자는 맞고 해석은 다름 |
| 독립 연구자들이 의장들의 논문을 Pangram에 돌려 24%, 36%, 45%, 69%를 얻었다. | 한 사람이다. Sergey Berezin이 6월 3일 LinkedIn 글에서 네 편의 논문을 밝히고 “이 논문들의 작성 과정에 대해서는 어떠한 주장도 하지 않는다”고 썼다[6]. 그의 글에는 본인의 논문이 게재 거부되었다는 말이 없다. | 사실, 출처 1건 (우리가 그의 처지를 과장했다) |
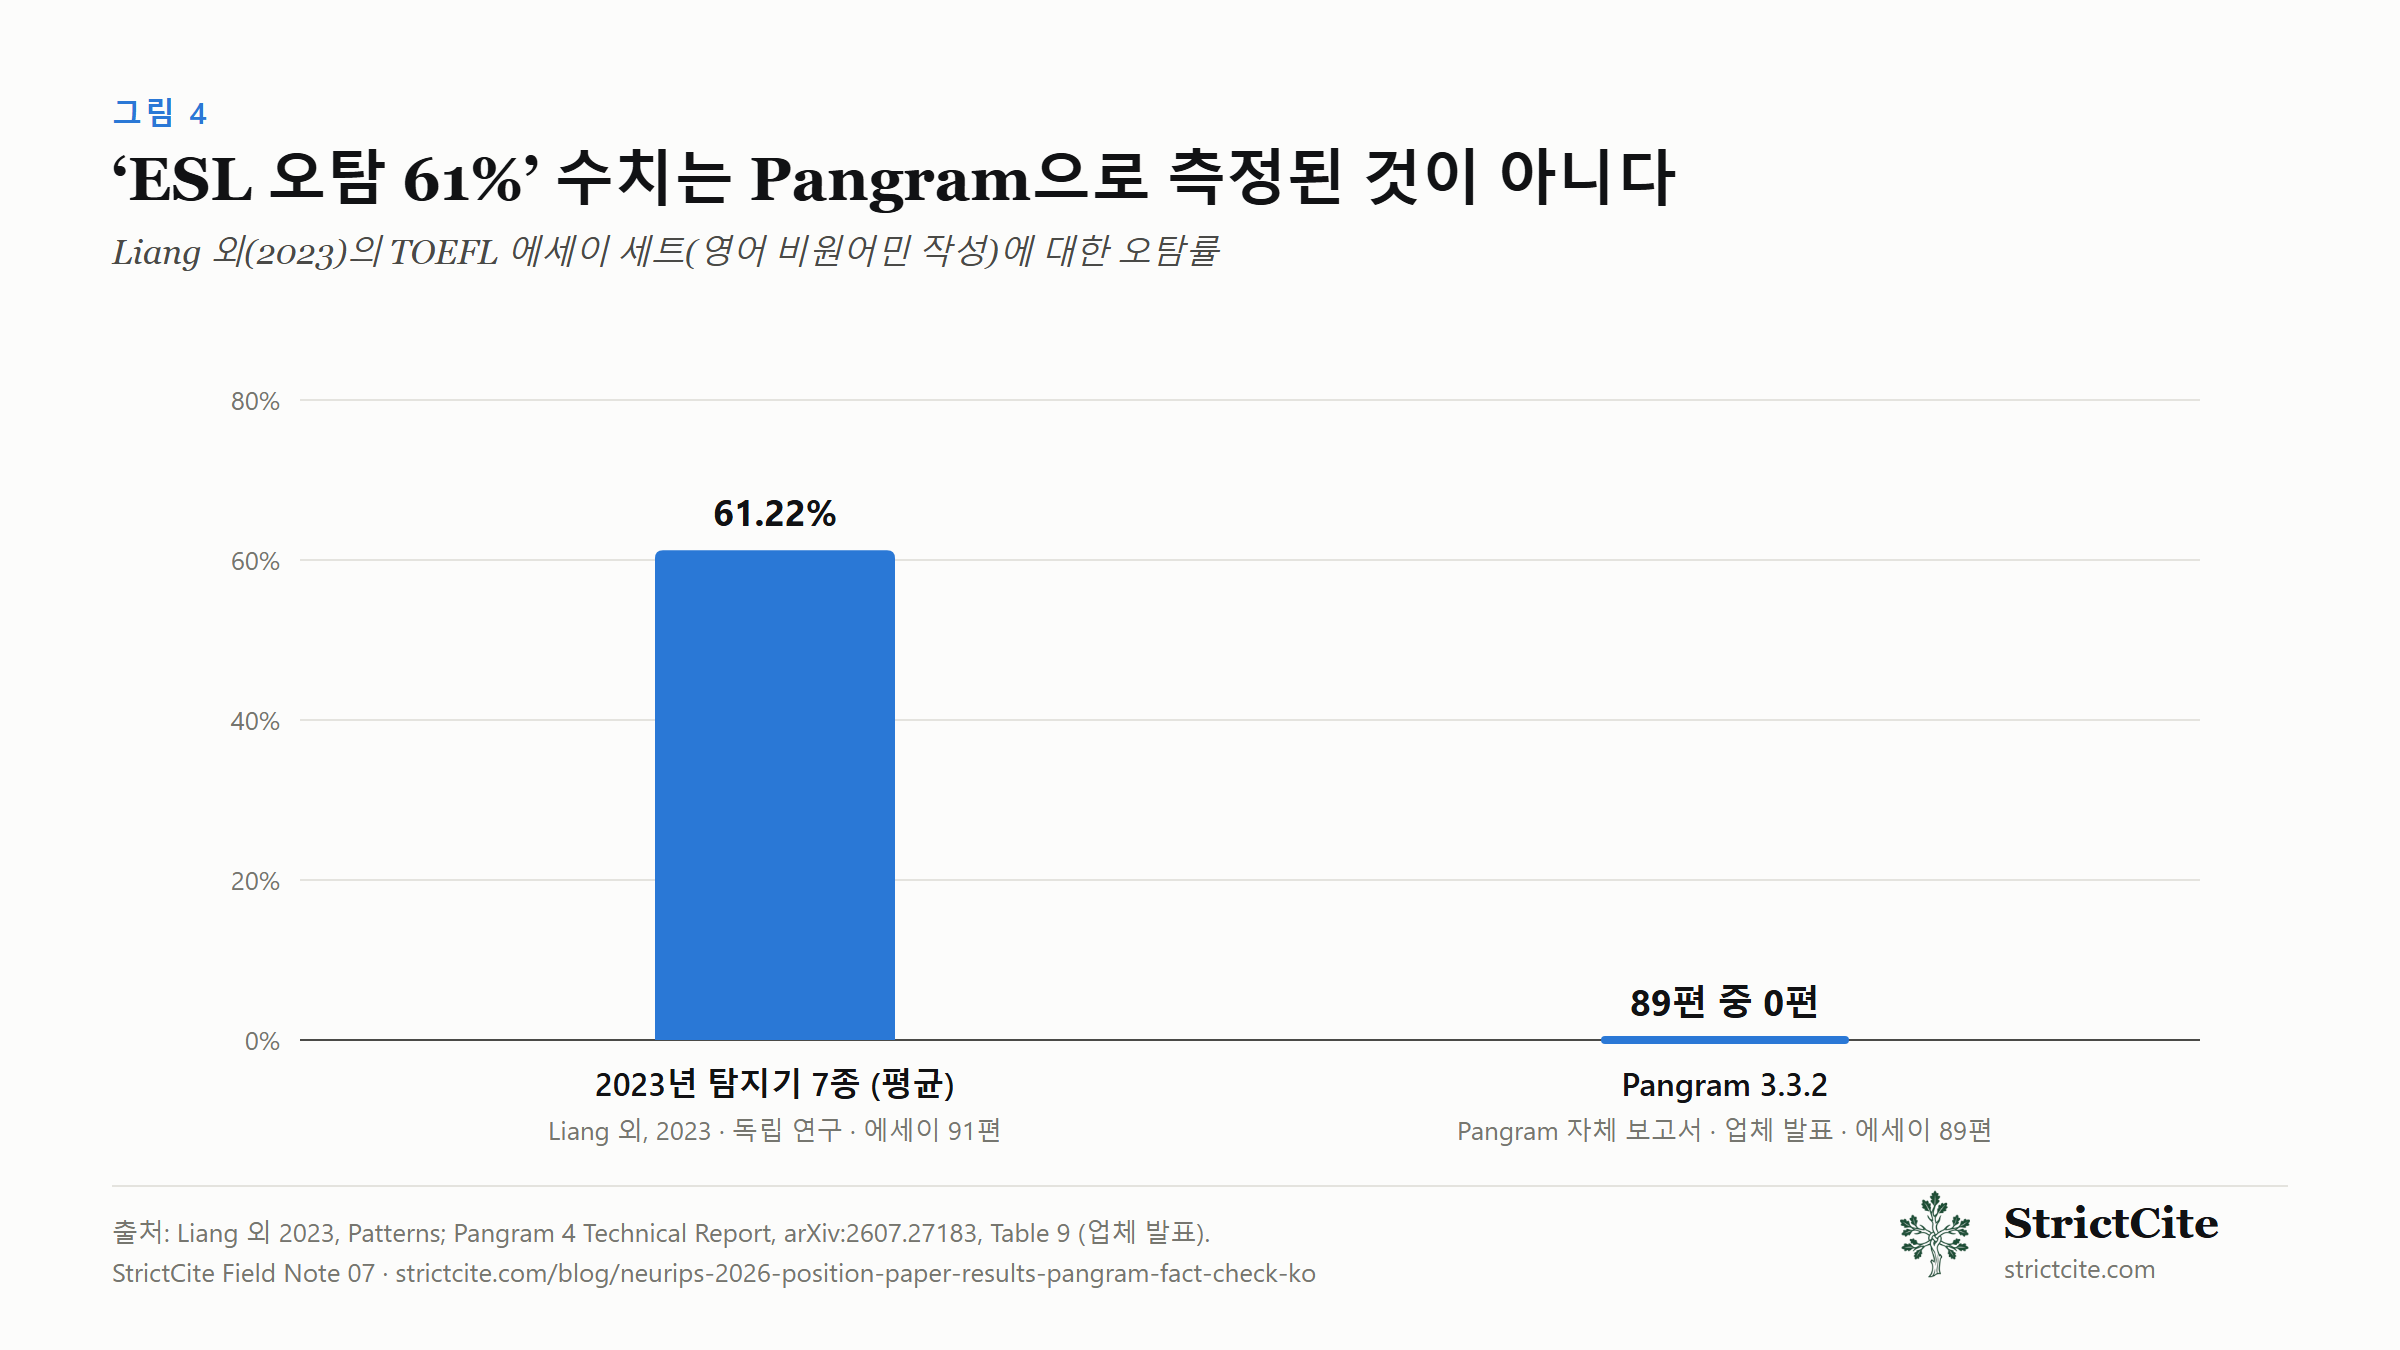
| Pangram은 비원어민에게 불리하다. 스탠퍼드 연구에서 TOEFL 에세이 오탐률이 61.22%였다. | 61.22%는 Liang 외(2023)의 수치로, 다른 탐지기 7종을 테스트한 것이다[7]. Pangram이 아니다. 같은 TOEFL 에세이에서 Pangram 자체 보고서는 v3.3.2의 오탐을 89건 중 0건으로 보고한다[4]. 업체 측 데이터이며 독립적으로 재현되지 않았다. | Pangram에 대해서는 틀림 |
| 다른 NeurIPS 트랙에서 AI 사용이 10배 이상 늘었다. | Evaluations & Datasets 트랙에서 ≥90% 점수 논문이 0.8%(2025)에서 9.3%(2026)로 늘었다[1]. | 사실 |
| Substack이 유료 구독자용으로 Pangram을 도입하고 “Claudefishing”이라는 말을 만들었다. | Chris Best가 7월 21일 이 용어를 만들었다. 스캔은 100단어가 넘는 글에 작동하며 “요청한 사람에게만 분석을 보여준다”[8]. Best의 글은 이를 유료 구독자로 한정하지 않는다. | 부분적으로 틀림 |
| 9월 내내 거대한 Reddit 스레드에서 커뮤니티가 결집했다. | 인용할 만한 특정 스레드를 찾지 못해 반복하지 않는다. | 확인 불가 |
3. 우리가 9월 8일에 틀린 것
이전 Field Note[11]에는 오류가 네 개 있었다. 오늘 그 글을 정정하고 수정 표시를 했다. 이 글이 다른 이들의 같은 실수를 지적하기 때문에 여기에 밝힌다.
- 79편 그룹을 “점수 0.8 초과 + 단독 저자”라고 썼다. 실제 기준은 위 표에 있다.
- 22편 그룹이 AI 사용의 명시적 부인을 요구한다고 썼다. 신고하지 않은 저자도 포함된다.
- Sergey Berezin을 “게재 거부된 저자”라고 불렀다. 그의 글은 그렇게 말하지 않는다.
- “Claude체”에 대한 심사자들의 불만을 그의 글에 귀속시켰다. 인용한 출처에서 그 표현을 찾을 수 없어 삭제했다.
4. NeurIPS가 사용한 버전에 대해 Pangram 자체 보고서가 말하는 것
의장들은 Pangram v3.3.2로 트랙을 심사했다[1]. 7월 29일 Pangram Labs는 v4 기술 보고서를 arXiv에 공개했고[4], 보고서의 거의 모든 표가 v4를 3.3.2와 비교한다. 우리가 아는 한, 트랙을 심사한 모델에 대해 공개된 유일한 벤치마크다. 업체가 고르거나 직접 돌린 벤치마크에서 측정한 업체 측 데이터이며, 포지션 페이퍼로 측정한 것이 아니다. 이 단서를 전제로, 수치는 다음과 같다.
| 지표 (Pangram 자체 보고서) | v3.3.2 | v4 | 위치 |
|---|---|---|---|
| 오탐, 사람이 쓴 영어 텍스트 100만 건 이상 | 0.0539% | 0.0041% | §5.3 |
| 미탐, AI 텍스트 52만 건 | 1.99% | 0.34% | §5.2 |
| 오탐, 영어 학습자 텍스트 24,586건 | 2건 (0.0081%) | 1건 (0.0041%) | Table 9 |
| … 그중 Liang 외 TOEFL 에세이 (n=89) | 0 | 0 | Table 9 |
| AI로 다듬은 텍스트를 “AI”로 판정 (n=11,363) | 0.18% | 0.01% | Table 4 |
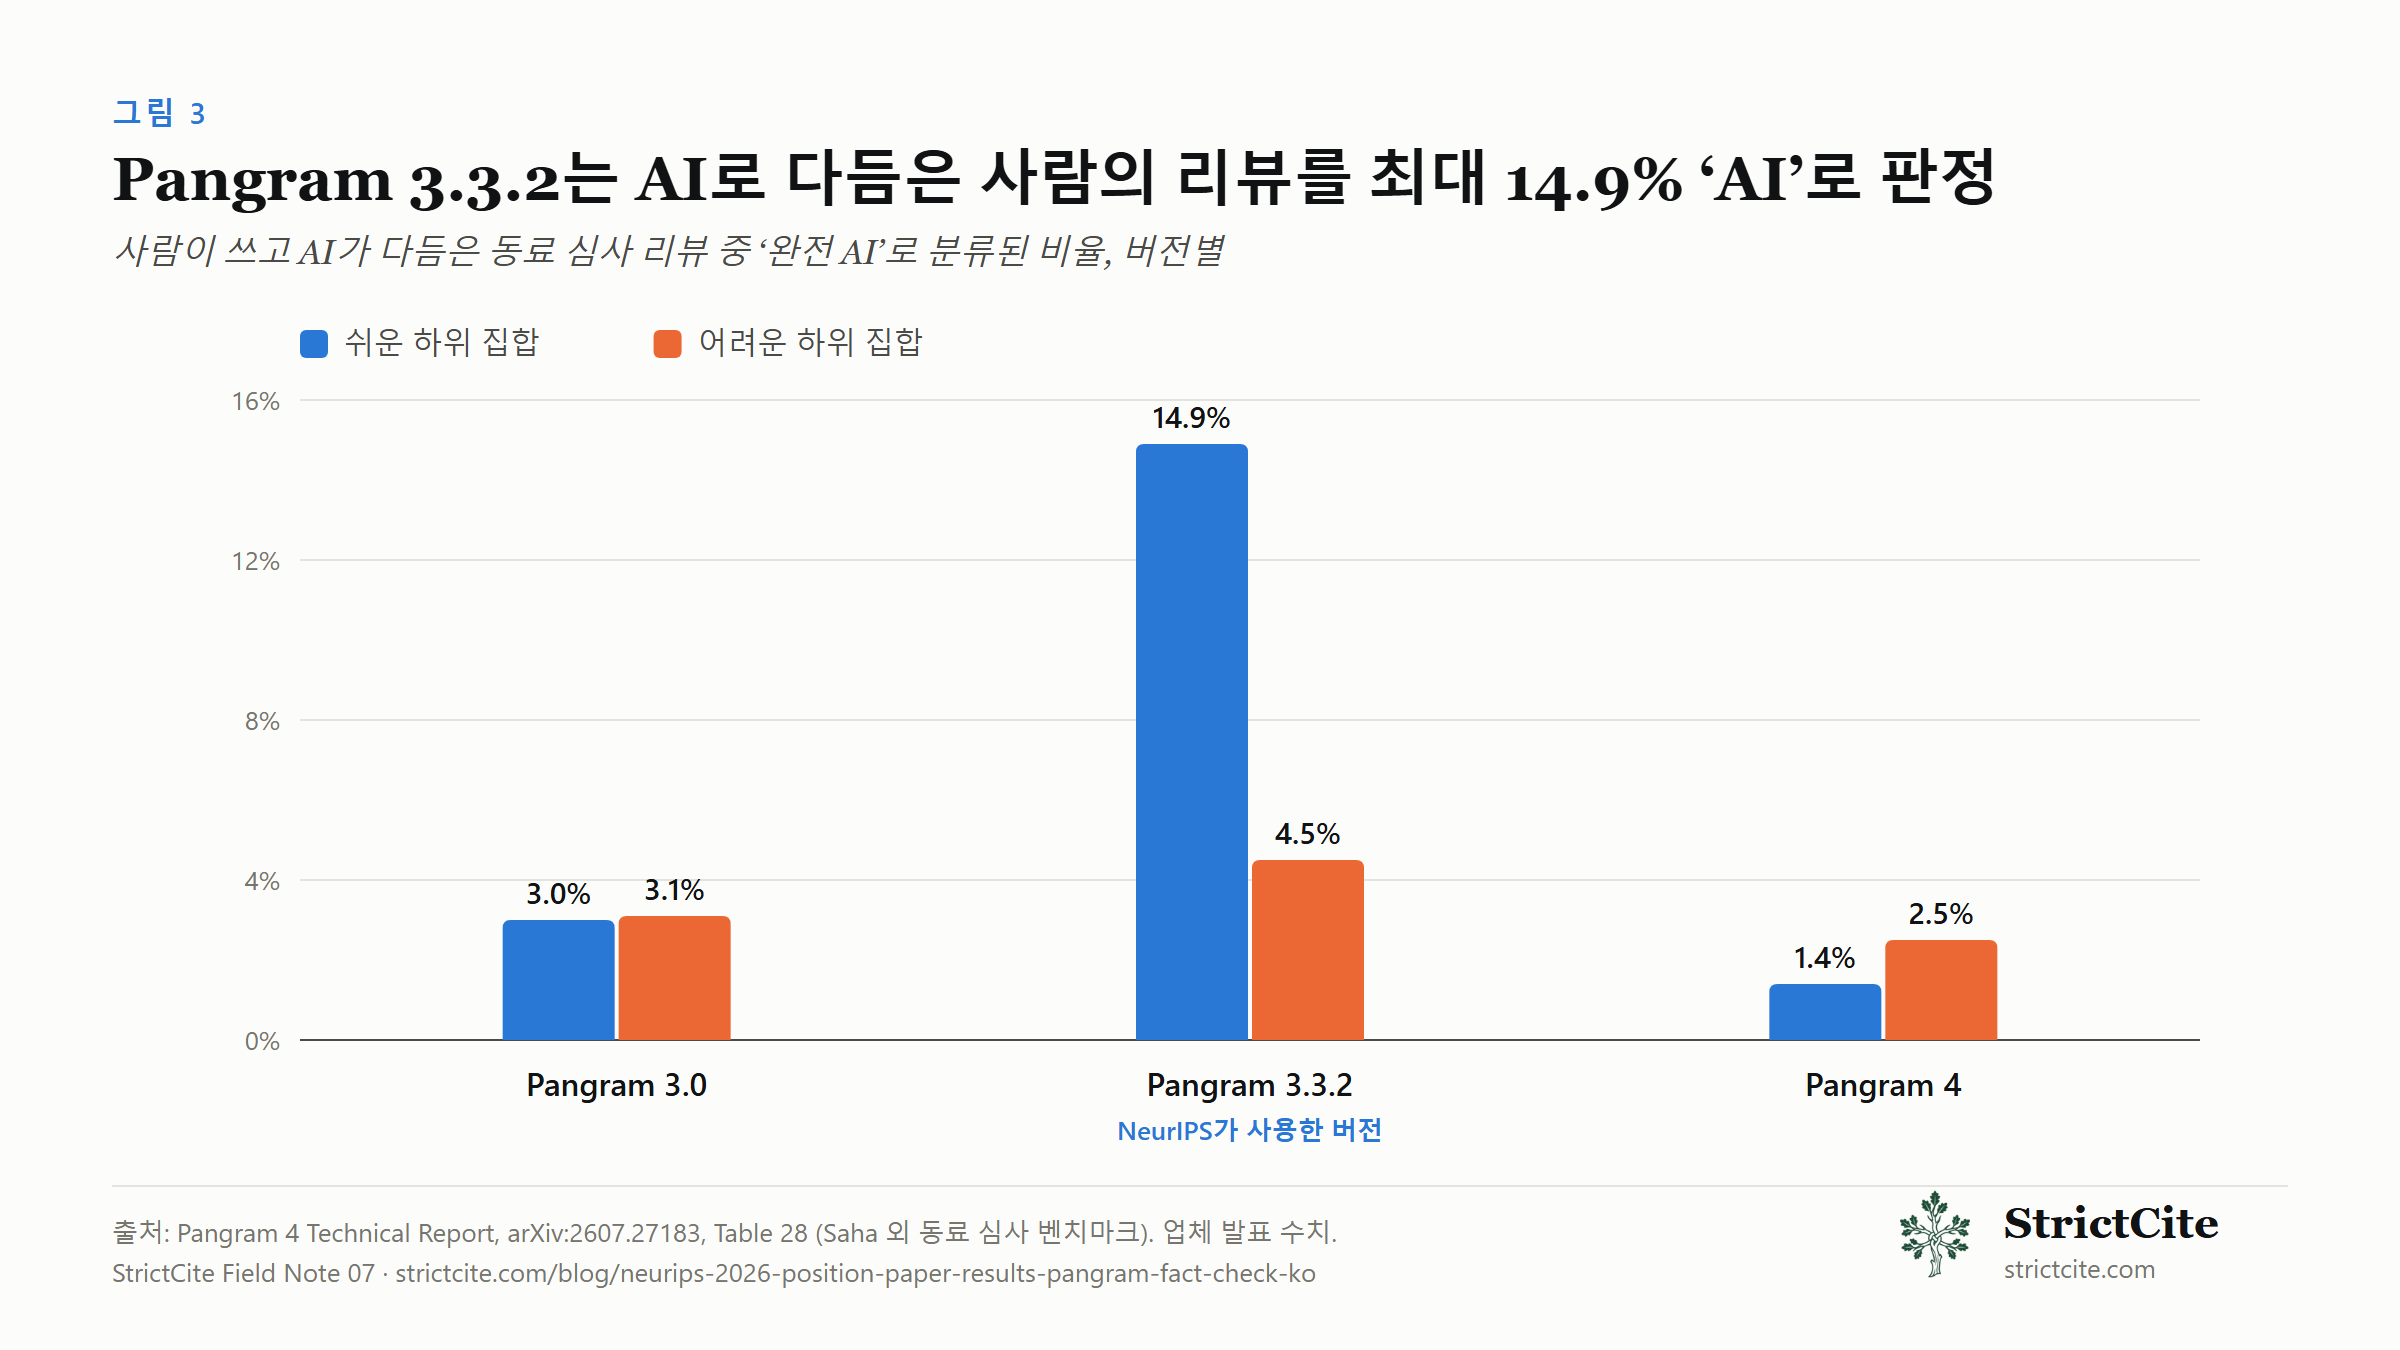
| AI로 다듬은 사람의 동료 심사 리뷰를 “AI”로 판정, 쉬운/어려운 하위 집합 | 14.9% / 4.5% | 1.4% / 2.5% | Table 28 |
| AI가 크게 수정한 텍스트를 “Mixed”로 올바르게 판정 (n=14,990) | 5.54% | 55.01% | Table 5 |
| 혼합 문서에서 AI 비율 추정의 평균 오차 | 28.6%p | 5.9%p | Table 7 |
여기서 세 가지를 읽을 수 있고, 첫 번째는 우리가 앞서 보도한 반발과 반대 방향이다.
순수하게 사람이 쓴 글은 위험 지점이 아니다. v3.3.2의 보고된 오탐률 0.0539%라면, 포지션 페이퍼가 업체 테스트 세트와 비슷하게 행동한다는 가정 하에 969편 전체에서 예상되는 오탐은 약 0.5건이다. 그 가정이 맞는다는 것을 보인 사람은 없다. 그러나 이 숫자가 대략이라도 맞다면, 완전히 사람이 쓴 논문에 대한 오탐으로는 18.4%의 게재 거부율을 설명할 수 없다. 설명은 어떤 형태로든 AI와 관련되어야 한다. AI 초안 작성이거나, 정책이 허용한 AI 교정이다.
흔히 말하는 ESL 주장은 Pangram의 데이터와 맞지 않는다. 다른 탐지기들에서 널리 인용되는 61.22%를 낳은 바로 그 TOEFL 에세이에서, v3.3.2의 오탐은 0건이었다. 다만 보고서는 업체가 이 영역을 어려운 사례로 취급한다는 것을 보여준다. 채택하지 않은 학습 설계를 설명하면서 오류가 “특정 문체, 즉 학술적 글쓰기와 ESL 에세이에 집중되었다”고 쓴다[4]. 비원어민 저자의 학술 글에 대한 v3.3.2의 독립적 테스트는 찾지 못했다.
사람이 쓰고 AI가 다듬은 글에서 v3.3.2가 가장 약했다. 사람이 쓴 뒤 AI가 다듬은 동료 심사 리뷰에서, v3.3.2는 쉬운 하위 집합의 14.9%를 완전한 “AI”로 판정했다. 같은 분할에서 v4의 10배다. 보고서가 Pangram 3.0으로 표시한 행은 3.0%이므로, NeurIPS가 사용한 버전은 이 분할에서 이전 버전과 후속 버전 모두보다 나빴다. 보고서는 또 혼합 텍스트에 대한 3.3.2의 동작을 “양극화되어 있다”고 부른다. AI 보조 텍스트를 Mixed보다 Human이나 AI로 분류하는 경향이 있다는 것이다. 이것이 바로 트랙 정책이 명시적으로 허용한 범주다(“교정(copy-editing) 또는 이와 유사한 주변적 변경”[1]). 의장들도 이를 테스트했다. FAccT 2022 논문 10편에서 뽑은 100단어 발췌문에 대해, 그들이 시도한 허용 범위의 수정은 하나도 플래그되지 않았다[1]. 10개 샘플은 업체가 더 큰 벤치마크에서 낸 수치에 비하면 작은 테스트다.
5. 게재 거부를 직접 언급한 ICML 논문
Saha, Juneja, Chaudhuri, Sajeevan, Shah, Pruthi의 논문 Policies Permitting LLM Use for Polishing Peer Reviews Are Currently Not Enforceable은 ICML 2026에 게재된다[5]. 우리가 찾은 가장 신중한 출처이며, 결론은 논쟁의 어느 쪽보다도 미묘하다. 핵심 발견은 테스트한 탐지기 5종 모두가 “LLM으로 다듬은 리뷰의 무시할 수 없는 비율을 AI 생성으로 잘못 분류한다”는 것이다. Pangram은 AI로 다듬은 사람의 리뷰 중 3.1%를 “Mixed”도 아닌 “AI”로 판정했다. 부록에서는:
- Grammarly: 사람이 쓴 리뷰 100건에 Grammarly의 모든 제안을 수락한 뒤, Pangram은 “Human” 89건, “Mixed” 11건, “AI” 0건을 반환했다.
- 기계 번역: Google Translate와 DeepL로 독일어, 중국어, 일본어를 거쳐 다시 영어로 옮긴 리뷰 중 1.1%~4.5%를 Pangram이 완전한 “AI”로 판정했다. 언어와 번역기 순서에 따라 달랐다.
- 문체 지시를 붙인 교정(“영국식 영어로”, “짧은 문장으로”): 2.42%가 “AI”로 판정되었다.
번역 결과는 다른 언어로 초안을 쓰는 사람들에게 중요하다. 의장들의 정책 표는 “번역/역번역”을 경계선상의 허용으로 분류한다[1].
NeurIPS에 대해 저자들은 자신들의 수치가 게재 거부가 틀렸다는 증거가 아니라고 분명히 한다.
“AI로 다듬은(H-AI) 리뷰에 대한 약 3%의 오탐률은 논문 단위가 아니라 창(window) 단위의 비율로 이해하는 것이 가장 적절하다 … 창 단위 오탐률이 서로 독립이라면, LLM으로 교정만 한 논문의 창 50% 이상이 플래그될 가능성은 낮다 … 그러나 핵심 단서는 이 추론이 같은 논문 안의 창들이 서로 독립이라고 가정한다는 점이다. 저자 개인의 문체는 창들에 걸쳐 상관된 오류를 낳을 수 있다 … 따라서 창 단위 오탐률을 어느 방향으로도 논문 전체로 외삽해서는 안 된다.”[5]
v3.3.2의 더 나쁜 수치로 이 논증을 다시 계산해 보았다. 교정만 한 논문의 각 창이 독립적으로 14.9% 확률로 플래그된다면, 창 30개짜리 논문에서 절반 이상이 플래그될 확률은 약 100만분의 1이다. 모든 것은 독립성 가정에 달려 있다. 이 가정은 저자의 문체가 문단에서 문단으로 아무 영향도 주지 않는다고 말하지만, 일관된 문체야말로 어떤 사람의 글을 알아볼 수 있게 만드는 것이다. 이를 측정한 사람은 없다. 이 가정에 가장 크게 노출된 기준은 문턱을 0.8이나 0.9가 아닌 0.5로 둔 22편 그룹이다.
6. 의장들의 글에서 맞춰지지 않는 두 가지
어떤 창 설정이 게재 거부를 결정했는가. 의장들의 글 Table 3에 따르면 중간 창에서 12.7%(약 123편), 기본 창에서 42.7%(약 414편)가 ≥90%를 받았다. 결정 표인 Table 5는 추가 조건 없이 ≥0.9에서 77편을 게재 거부한다[1]. 표면적으로 77은 어느 쪽 숫자와도 맞지 않으며, 글은 Table 5가 어떤 점수를 썼는지 밝히지 않는다. 다른 점수 정의나 이후의 제외처럼 간단한 설명이 있을 수 있지만 글에는 없다. 저자는 어떤 점수에 적용되었는지 모르는 문턱을 검증할 수 없다.
심사자 쪽. 같은 정책은 심사자에게 “리뷰 작성에 AI 도구를 사용하지 않겠다고 서약”하도록 요구했다[1]. 글은 모든 투고를 심사했다고 설명하지만 리뷰를 심사했다는 설명은 없다. 강제 없는 서약이 얼마나 지켜지는지 참고하자면, ICML 2026의 무작위 실험에서 LLM 금지 정책에 배정된 심사자의 22.5%가 설문에서 그래도 LLM을 사용했다고 답했다[9]. 다른 학회이고 NeurIPS 심사자에 대해 직접 말해주는 것은 없다. 다만 의장들이 저자에게는 불충분하다고 판단한 서약이 심사자에게는 그대로 의존되고 있다는 것을 보여준다.
7. 아직 공개되지 않은 것
- 조건부 123편 중 몇 편이 자료를 제출했고, 몇 편이 인정되었으며, 몇 편이 철회했는지.
- 9월 24일 트랙이 몇 편의 포지션 페이퍼를 채택했는지.
- Table 5의 문턱이 어떤 창 설정과 점수 정의를 사용했는지.
- 게재 거부된 저자들이 자신의 점수와 텍스트가 어떻게 창으로 나뉘었는지를 확인할 수 있었는지.
- 비원어민 저자의 격식 있는 학술 문장에 대한 v3.3.2의 보정 결과. Pangram이든 누구든.
의장들이 이 중 무엇이든 공개하면 이 글을 업데이트하겠다. 해당 저자로서 통보 문구나 이의 결과 같은 1차 자료를 공유할 의향이 있다면 [email protected]으로 연락 주기 바란다. 검증할 수 없는 것은 게재하지 않는다.
8. 당사자이거나 다음 주기에 투고한다면
이 거부는 통상적인 게재 거부로 설명된다. 의장들의 글은 “통상적인 게재 거부(a standard desk-rejection)”라는 표현을 쓰며[1] 이를 부정행위 판정으로 설명하지 않는다. 논문이 더 이상 NeurIPS에서 심사 중이지 않으면, 다른 곳에 투고할 때의 통상적인 규칙이 적용된다. 새 학회의 중복 투고 및 AI 사용 규정을 확인하라.
구체적으로 신고하라. 22편 그룹에는 AI 미사용을 신고한 저자와 아무것도 신고하지 않은 저자가 모두 포함되었다. 빈 신고란은 부인과 같은 것으로 취급되었다.
버전 이력을 남겨라. 의장들이 요구한 자료는 AI 사용 전 체크포인트, AI 사용 후 체크포인트, 최종 논문, 그리고 AI 수정이 새로운 실질적 내용을 추가하지 않았음을 보여주는 분석이었다[1]. 그들은 “향후에는 이런 감사 기록이 기본이 될 것으로 예상한다”고 썼다. Overleaf 이력, Git 커밋, Google Docs 버전 기록은 작업하는 동안 이를 자동으로 만든다. 나중에 만들기는 매우 어렵다.
도구에 대한 증거를 알아 두라. 우리가 찾은 유일한 통제 실험에서, Grammarly 전체 교정은 Pangram의 “AI” 판정을 한 건도 만들지 않았다. 리뷰 전체의 기계 번역은 1.1–4.5%의 비율로 “AI” 판정을 받았다[5]. 둘 다 논문이 아니라 리뷰 길이의 텍스트에 대한 작은 테스트다.
탐지기의 대안을 주시하라. 한 제안인 greCAPTCHA(Payan, Gyevnár, Kasirzadeh & Shah, 9월 17일)는 문장을 채점하는 대신 저자가 자기 논문을 이해하고 있는지를 테스트한다. 시제품은 연구자 31명을 대상으로 실제 저자 여부를 AUC 0.90으로 예측했다[10]. 작은 시제품이며, 이를 사용하는 학회는 우리가 아는 한 없다.
9. 인용 검증이 할 수 있는 것과 할 수 없는 것
StrictCite는 AI 문장을 탐지하지 않으며, 이 글의 어떤 내용도 Pangram 대신 우리 제품을 쓰라는 주장이 아니다. 둘은 다른 질문에 답한다. Pangram은 누가 문장을 썼는지 추정하며, 4절과 5절에서 보듯 제작사의 벤치마크조차 불확실성을 ‘다듬어진 중간 지대’에 둔다. 참고문헌은 Crossref, OpenAlex, DBLP의 실제 기록으로 연결되거나 되지 않으며, 그 답은 직접 확인할 수 있다. 이것이 이번 주기 NeurIPS의 또 다른 게재 거부 메커니즘이고[12], 투고 전에 스스로 완전히 확인할 수 있는 쪽이다. 참고문헌은 strictcite.com에서 무료로 확인할 수 있다.