1. 9月24日に変わったこと、変わらなかったこと
Position Paper TrackのCall for Papersは、9月24日を最終判定日としている[2]。トラックに残っていた投稿が採否を知らされた日である。条件付きとされた123本の期限ではない。それらの著者は6月15日までにバージョン履歴の資料を提出しなければ、即時却下されることになっていた[1]。
変わらなかったのは公開記録である。9月26日時点で、NeurIPSブログの最新記事はアフィニティイベント(9月25日)と財政支援(9月16日)に関するものだ[3]。議長らの6月2日の投稿に追記はない。123件の資料のうち何件が認められたのか、何人が取り下げたのか、トラックが最終的に何本を採択したのかは、どこにも公表されていない。それらについての数字を目にしたなら、それはNeurIPS発のものではなく、我々は出典のある数字を見つけられなかった。
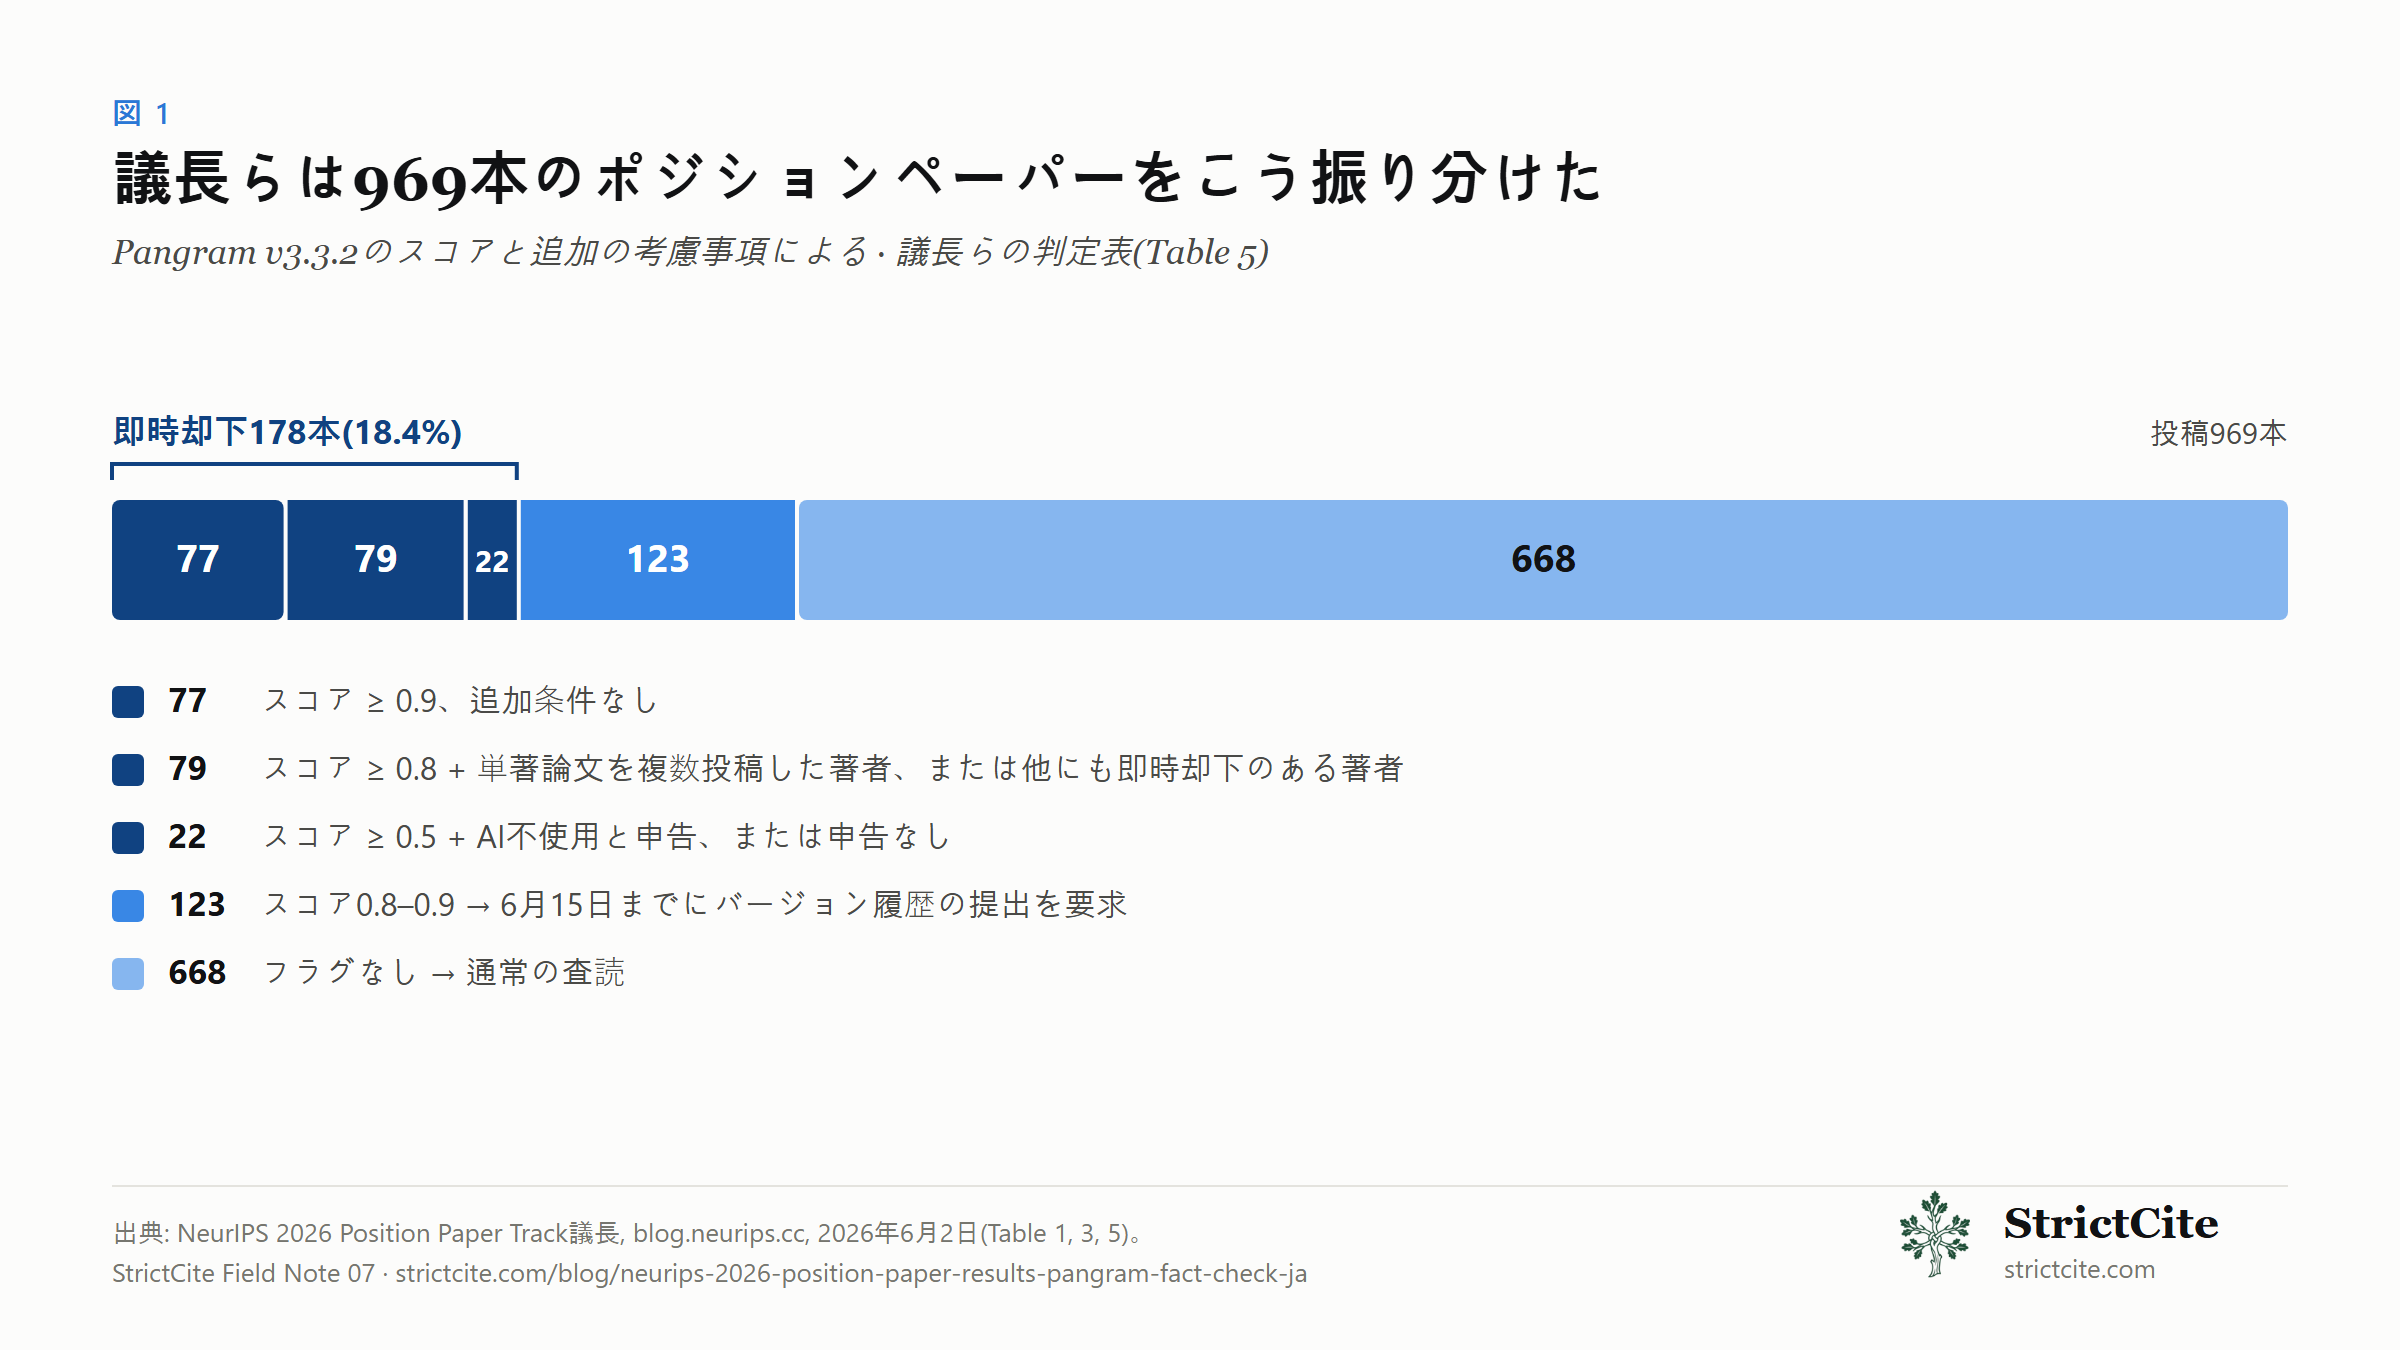
2. 12の主張を検証する
判定日前後の記事や要約で、そして我々の以前の記事でも、最も頻繁に繰り返された主張である。各判定は同じ行にリンクした出典に基づく。
| 主張 | 一次情報源の内容 | 判定 |
|---|---|---|
| 9月24日は条件付き123本の最終的な却下日だった。 | 証拠の提出期限は6月15日だった[1]。9月24日はトラック全体の最終判定日である[2]。 | 誤り |
| 1回のコミットに大きな文章の塊が現れた場合や、Grammarly・DeepLの使用を申告した場合、異議は退けられた。 | 出典は見つからなかった。資料は「PPTチームが審査」し[1]、結果は公表されていない。別に、統制された実験では、Grammarlyによる修正はPangramの「AI」判定を100件中0件しか受けなかった[5]。 | 未検証 |
| 79本はスコア0.8超かつ単著であることを理由に却下された。 | 基準はスコア≥0.8に加えて、「単著論文を複数投稿し、少なくとも1本が閾値を超える」著者、または「他にも少なくとも1件の即時却下がある」著者である[1]。単著であることだけでは該当しない。 | 誤り (我々も同様に書いた) |
| 22本は、著者がAI利用を否定したのにスコアが0.5を超えたため却下された。 | 基準はスコア≥0.5で、「著者がAIを使用していないと申告した、またはAI利用を申告しなかった」場合である[1]。申告欄を空欄にした著者も含まれる。 | 不完全 (我々も同様に書いた) |
| 178件の即時却下に異議申し立てはなかった。 | 「通常の状況では異議申し立ての対象とならない、通常の即時却下」[1]。123件は「Desk Reject with Appeal」とされている。 | 正しい(但し書きあり) |
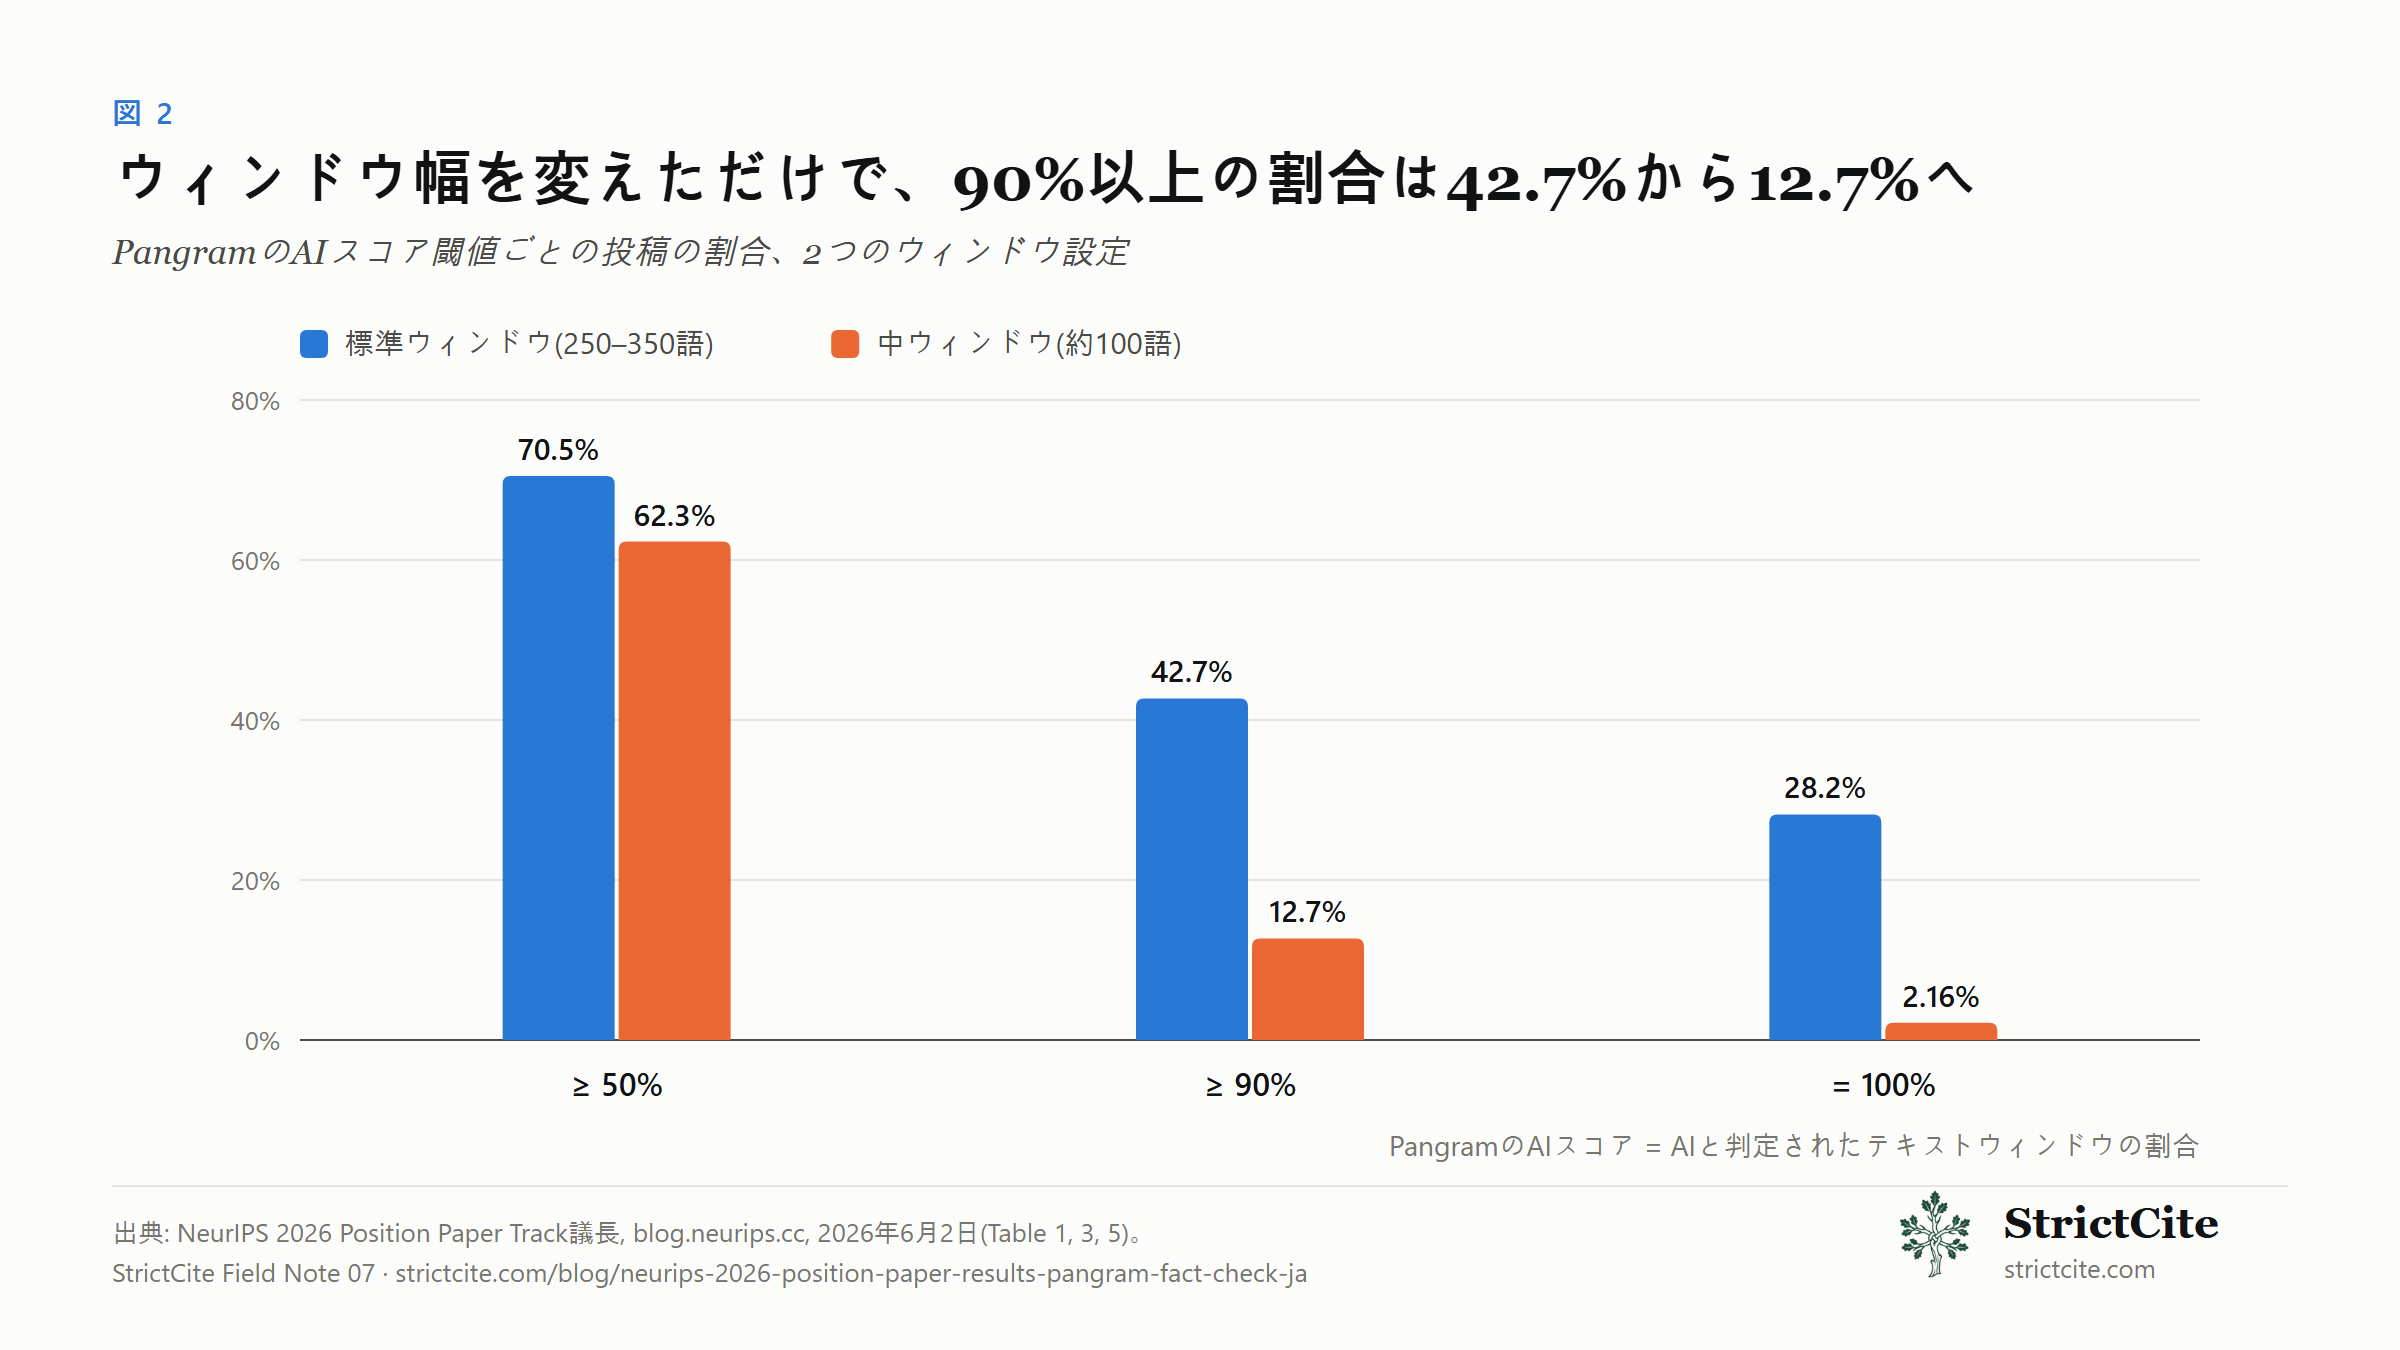
| 標準の250–350語のウィンドウでは、投稿の42.7%が90–100%のAIスコアだった。 | 議長らの投稿のTable 1とTable 3: ≥90%が42.7%、100%が28.2%、≥50%が70.5%[1]。 | 正しい |
| 議長らはフラグ率を下げるためにウィンドウを100語に縮めた。 | 数字は正しい。≥90%の割合は42.7%から12.7%に下がった。しかし動機は議長らが述べたものとは違う。彼らは小さなウィンドウが「AI利用の過大な判定」を減らすと述べ、それに伴う再現率(recall)の低下も公表している(Table 2)[1]。 | 数字は正しく、解釈は違う |
| 独立した研究者たちが議長らの論文をPangramにかけ、24%、36%、45%、69%という結果を得た。 | 1人である。Sergey Berezinが6月3日のLinkedIn投稿で4本の論文を挙げ、「これらの論文の執筆過程について、私は一切主張しない」と書いた[6]。彼の投稿には、自身の論文が即時却下されたという記述はない。 | 正しい(出典1件) (我々は彼の立場を誇張した) |
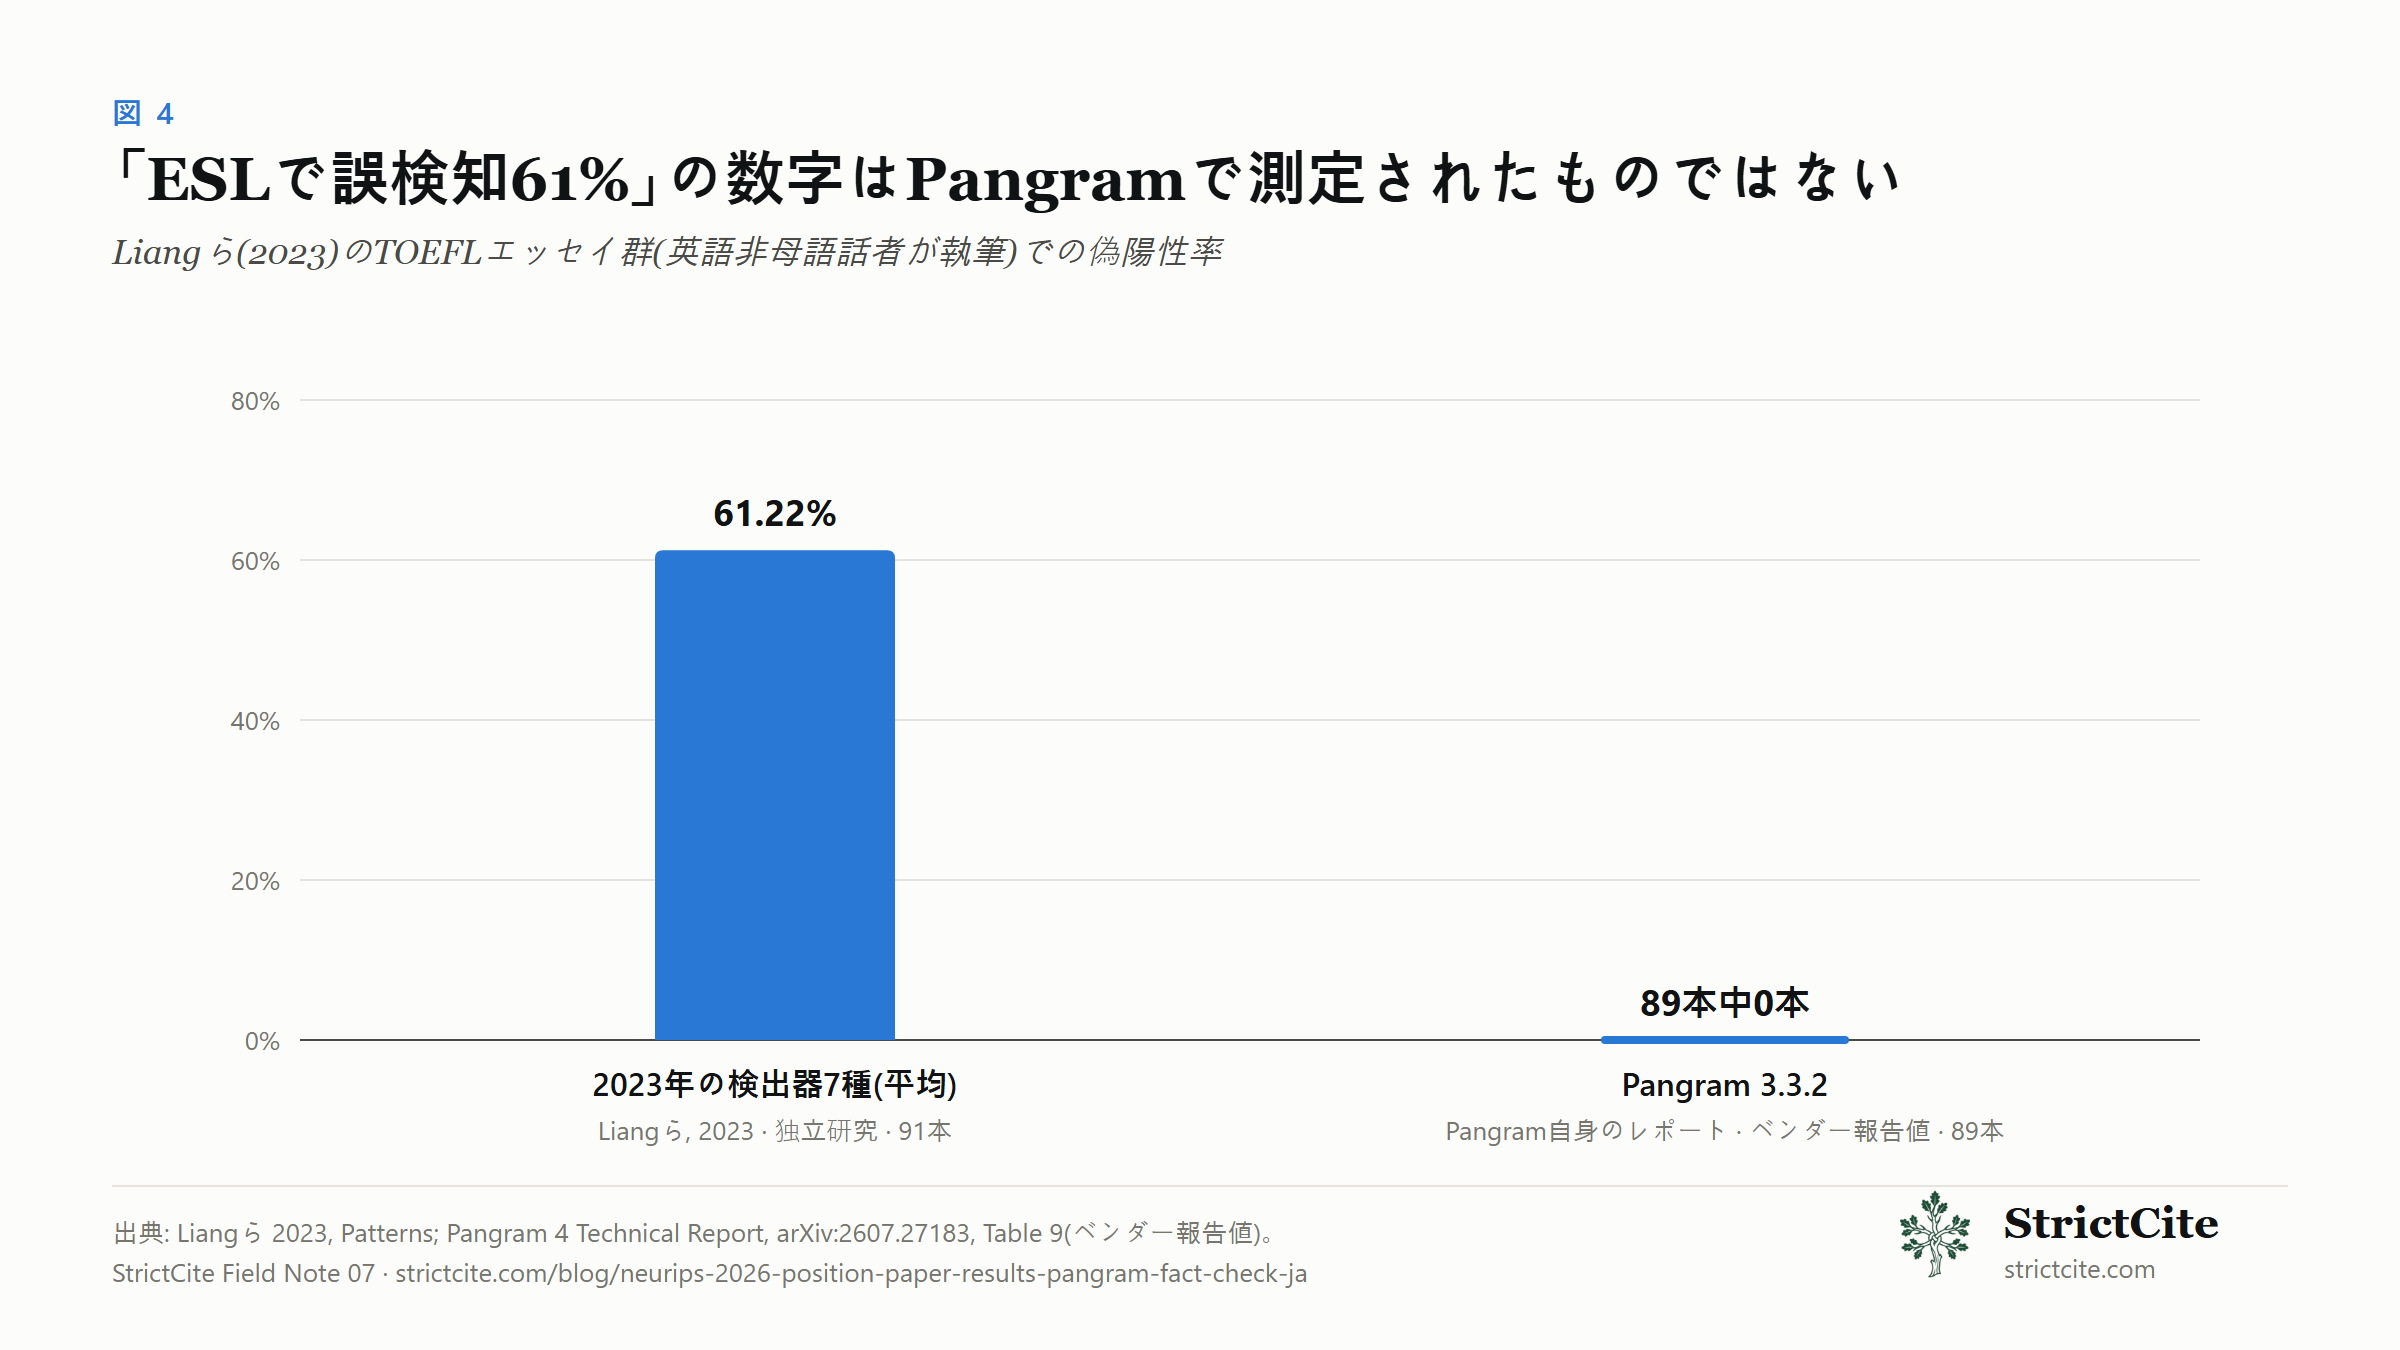
| Pangramは非ネイティブの書き手に不利だ。スタンフォードの研究でTOEFLエッセイの誤検知率は61.22%だった。 | 61.22%はLiangら(2023)の数字で、他の7つの検出器を検証したものであり[7]、Pangramではない。同じTOEFLエッセイについて、Pangram自身のレポートはv3.3.2の偽陽性を89件中0件と報告している[4]。ベンダーのデータであり、独立には再現されていない。 | Pangramについては誤り |
| NeurIPSの別のトラックでAI利用が10倍以上に増えた。 | Evaluations & Datasetsトラックで、スコア≥90%の論文は0.8%(2025年)から9.3%(2026年)に増えた[1]。 | 正しい |
| Substackが有料購読者向けにPangramを導入し、「Claudefishing」という言葉を作った。 | Chris Bestが7月21日にこの言葉を作った。スキャンは100語を超える文章に対して機能し、「分析はそれを求めた人にだけ表示される」[8]。Bestの投稿はこれを有料購読者に限定していない。 | 一部誤り |
| 9月を通じて巨大なRedditスレッドでコミュニティが結集した。 | 引用できる特定のスレッドが見つからなかったため、繰り返さない。 | 未検証 |
3. 我々が9月8日に間違えたこと
以前のField Note[11]には4つの誤りがあった。本日その記事を訂正し、更新の旨を記した。本稿は他者の同じ誤りを指摘しているので、ここに明記する。
- 79本の区分を「スコア0.8超 + 単著」と書いた。実際の基準は上の表のとおりである。
- 22本の区分がAI利用の明示的な否定を要件とすると書いた。申告しなかった著者も含まれる。
- Sergey Berezinを「却下された著者」と呼んだ。彼の投稿はそう述べていない。
- 「Claude語り」に関する査読者の不満を彼の投稿に帰した。引用した出典にその表現は見当たらず、削除した。
4. NeurIPSが使用したバージョンについて、Pangram自身のレポートが語ること
議長らはPangram v3.3.2でトラックを審査した[1]。7月29日、Pangram Labsはv4の技術レポートをarXivで公開し[4]、その表のほぼすべてがv4と3.3.2を比較している。我々の知る限り、トラックを審査したモデルについて公開された唯一のベンチマークである。ベンダーが選んだ、あるいは自ら実行したベンチマークで測定したベンダーのデータであり、ポジションペーパーで測ったものではない。この但し書きのうえで、数値は次のとおりである。
| 指標(Pangram自身のレポート) | v3.3.2 | v4 | 箇所 |
|---|---|---|---|
| 偽陽性、人間が書いた英語テキスト100万件超 | 0.0539% | 0.0041% | §5.3 |
| 偽陰性、AIテキスト52万件 | 1.99% | 0.34% | §5.2 |
| 偽陽性、英語学習者のテキスト24,586件 | 2件(0.0081%) | 1件(0.0041%) | Table 9 |
| … うちLiangらのTOEFLエッセイ(n=89) | 0 | 0 | Table 9 |
| AIで推敲したテキストを「AI」と判定(n=11,363) | 0.18% | 0.01% | Table 4 |
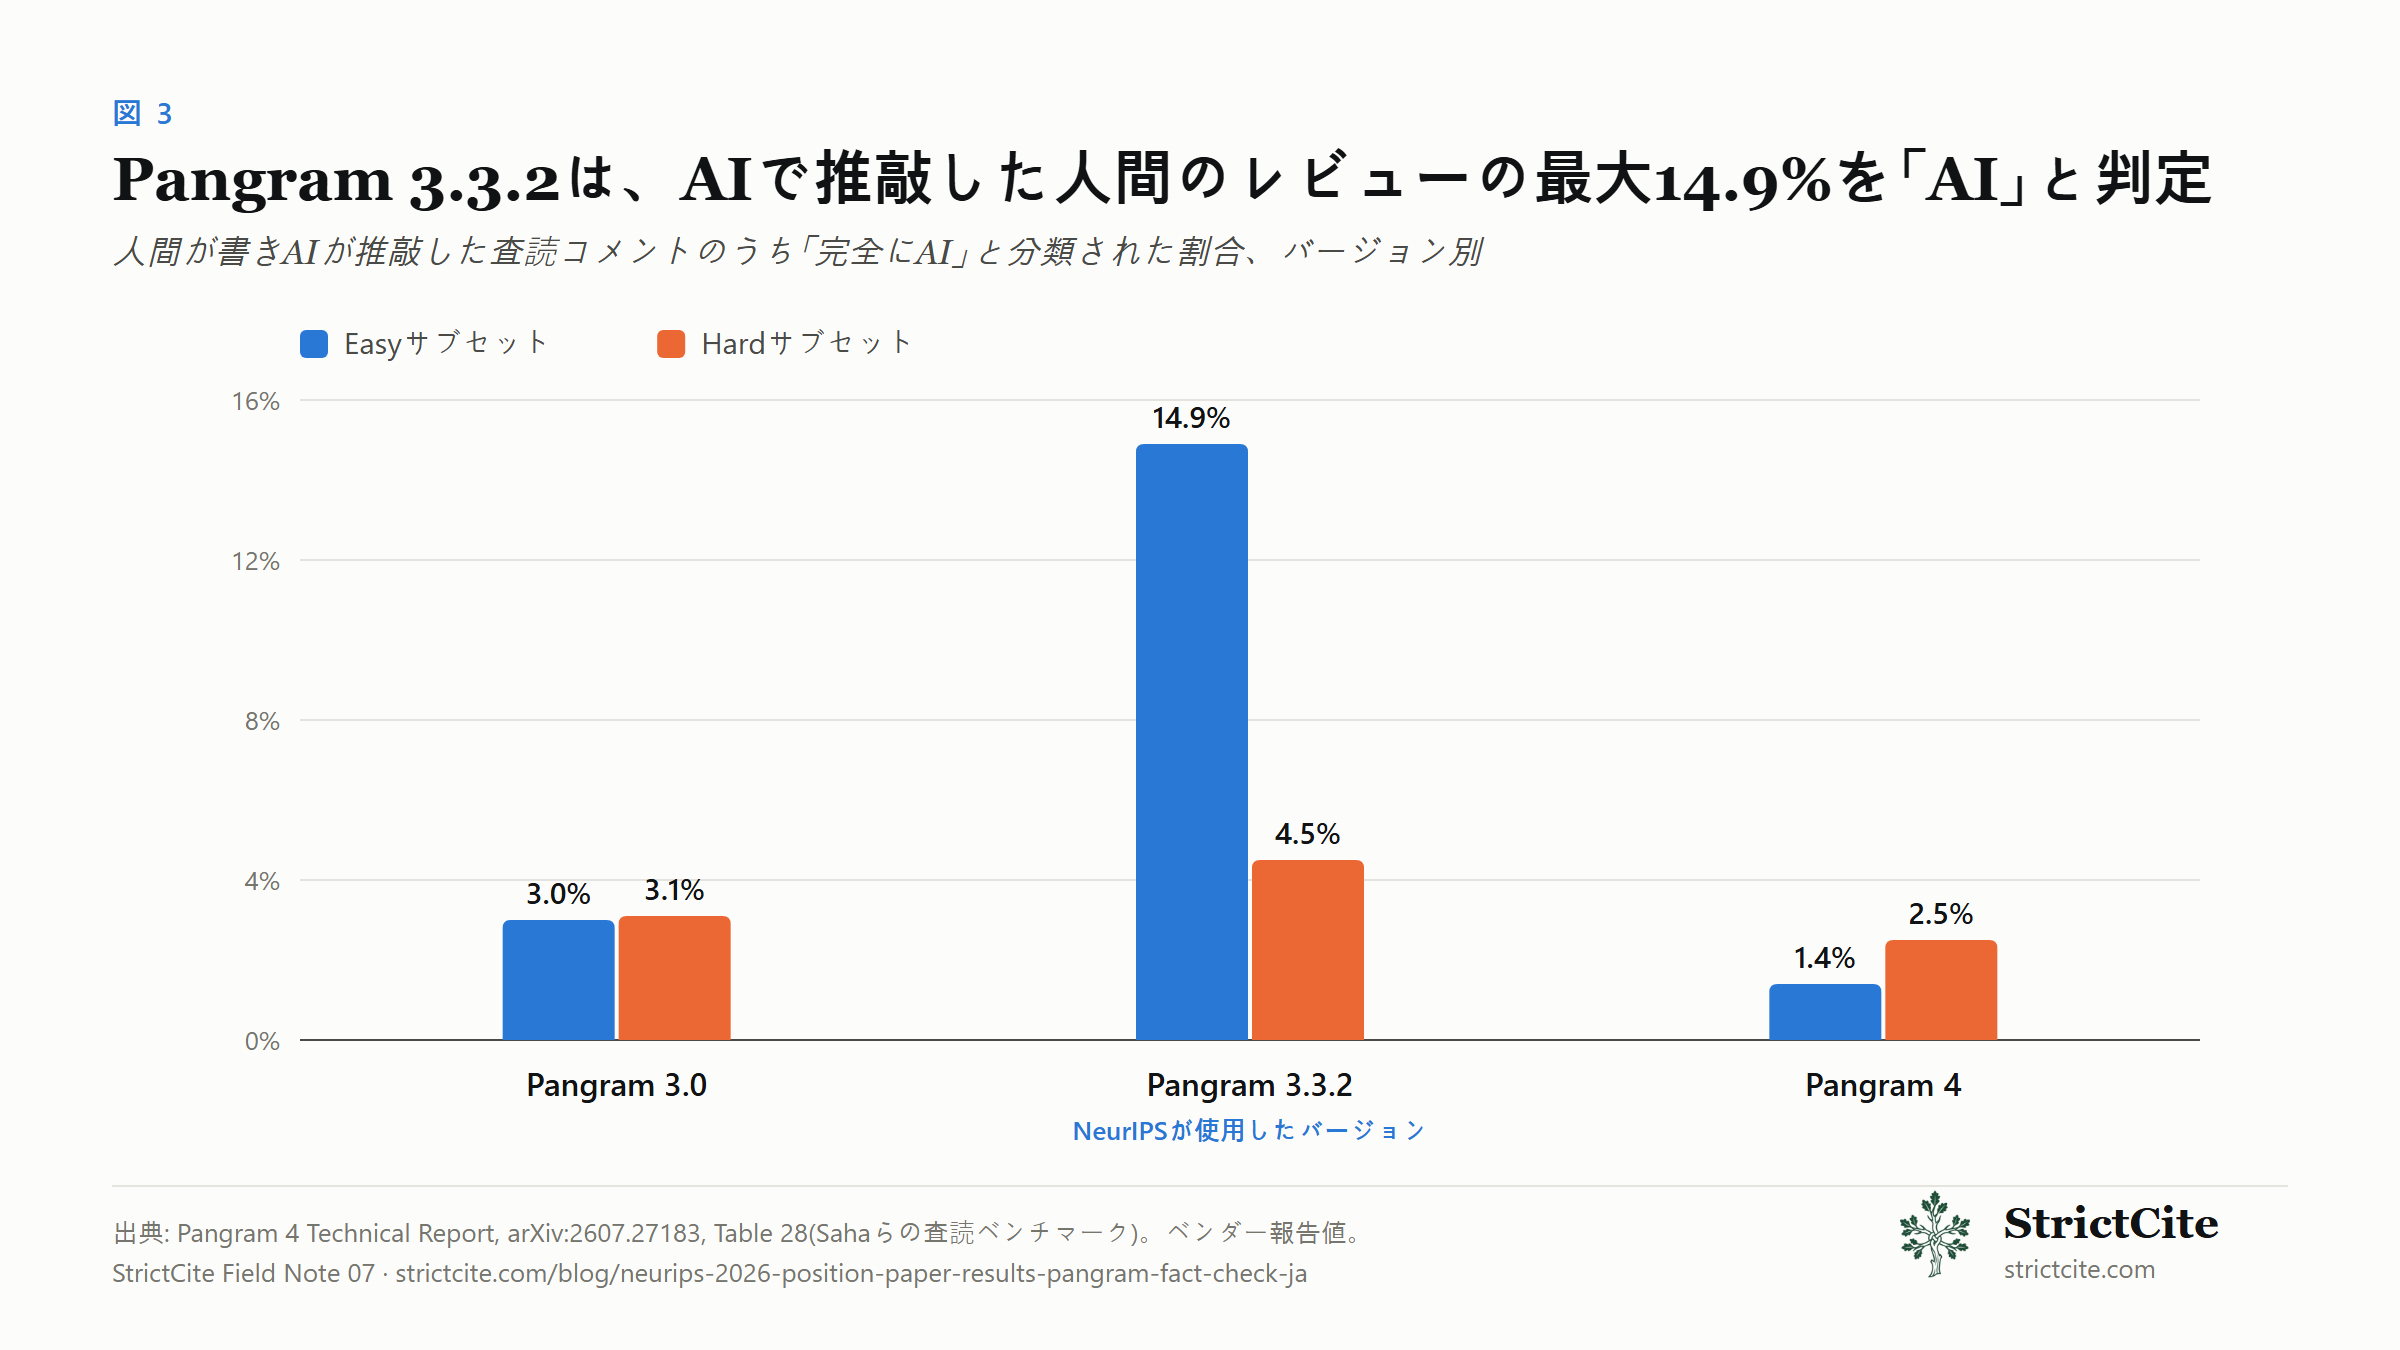
| AIで推敲した人間の査読コメントを「AI」と判定、Easy/Hardサブセット | 14.9% / 4.5% | 1.4% / 2.5% | Table 28 |
| AIが大きく手を入れたテキストを正しく「Mixed」と判定(n=14,990) | 5.54% | 55.01% | Table 5 |
| 混在文書でのAI比率推定の平均誤差 | 28.6ポイント | 5.9ポイント | Table 7 |
ここから3つのことが読み取れる。1つ目は、我々が以前報じた反発とは逆の方向を示す。
純粋に人間が書いた文章は、リスクの所在ではない。v3.3.2の報告された偽陽性率0.0539%なら、ポジションペーパーがベンダーのテストセットと同様に振る舞うと仮定すれば、969本全体で予想される偽陽性は約0.5件である。その仮定が成り立つことを示した人はいない。しかしこの数字がおおよそでも正しければ、完全に人間が書いた論文への偽陽性では18.4%の却下率を説明できない。説明には何らかの形でAIが関わっているはずだ。AIによる下書きか、方針が認めていたAIによる推敲である。
よく言われるESLの主張は、Pangramのデータと合わない。他の検出器について広く引用される61.22%を生んだまさにそのTOEFLエッセイで、v3.3.2の偽陽性は0件だった。ただしレポートは、ベンダーがこの領域を難しいケースとして扱っていることを示している。採用しなかった学習設計を説明する中で、誤りが「特定の文体、すなわち学術的な文章とESLのエッセイに集中した」と書いている[4]。非ネイティブ著者の学術的な文章についてv3.3.2を独立に検証したものは見つからなかった。
人間が書きAIが推敲した文章で、v3.3.2は最も弱かった。人間が書いた後にAIが推敲した査読コメントについて、v3.3.2はEasyサブセットの14.9%を完全な「AI」と判定した。同じ分割でのv4の10倍である。レポートがPangram 3.0とラベル付けした行は3.0%なので、NeurIPSが使用したバージョンはこの分割で前のバージョンにも後継版にも劣っていた。レポートはまた、混在テキストに対する3.3.2の挙動を「二極化している」と呼んでいる。AI支援のテキストをMixedではなくHumanかAIに分類しがちだということだ。これはトラックの方針が明示的に認めていた範囲(「コピーエディティングやそれに類する周辺的な変更」[1])そのものである。議長らもこれを検証した。FAccT 2022の論文10本から抜き出した100語の抜粋について、彼らが試した許容範囲の修正はいずれもフラグされなかった[1]。10サンプルは、ベンダーがより大きなベンチマークで出した数字と比べれば小さな検証である。
5. 却下を名指しで論じたICML論文
Saha、Juneja、Chaudhuri、Sajeevan、Shah、Pruthiの論文Policies Permitting LLM Use for Polishing Peer Reviews Are Currently Not EnforceableはICML 2026に掲載される[5]。我々が見つけた中で最も慎重な情報源であり、その結論は議論のどちらの側よりも繊細である。主な発見は、検証した5つの検出器すべてが「LLMで推敲したレビューの無視できない割合をAI生成と誤分類する」ことだ。Pangramは、AIで推敲した人間のレビューの3.1%を、「Mixed」ですらなく「AI」と判定した。付録では:
- Grammarly:人間が書いたレビュー100件でGrammarlyの提案をすべて受け入れた後、Pangramは「Human」89件、「Mixed」11件、「AI」0件を返した。
- 機械翻訳:Google TranslateとDeepLでドイツ語、中国語、日本語を経由して英語に戻したレビューのうち、1.1%〜4.5%をPangramは完全な「AI」と判定した。言語と翻訳器の順序によって異なった。
- 文体の指示を付けた推敲(「イギリス英語で」「短い文で」): 2.42%が「AI」と判定された。
翻訳の結果は、別の言語で下書きする人にとって重要である。議長らの方針表は「翻訳/逆翻訳」を境界線上で許容と分類している[1]。
NeurIPSについて、著者らは自分たちの数字が却下の誤りを証明するものではないと明言している。
「AIで推敲された(H-AI)レビューに対する約3%の偽陽性率は、論文単位ではなくウィンドウ単位の率として理解するのが最も適切である … ウィンドウ単位の偽陽性率が独立であれば、LLMで推敲しただけの論文のウィンドウの50%以上がフラグされる可能性は低い … しかし重要な但し書きは、この推論が同じ論文内のウィンドウ同士の独立を仮定している点である。著者個人の文体は、ウィンドウをまたいで相関した誤りを生む可能性がある … したがって、ウィンドウ単位の偽陽性率を、どちらの方向にも論文全体へ外挿すべきではない。」[5]
v3.3.2のより悪い数字でこの議論を計算し直した。推敲しただけの論文の各ウィンドウが独立に14.9%でフラグされるなら、30ウィンドウの論文で半分以上がフラグされる確率は約100万分の1である。すべては独立性の仮定にかかっている。この仮定は著者の文体が段落から段落へ何の影響も持たないと言っているが、一貫した文体こそが、ある人の文章を見分けられるものにしている。これを測定した人はいない。この仮定の影響を最も受けるのは、閾値を0.8や0.9ではなく0.5に置いた22本の区分である。
6. 議長らの投稿で辻褄が合わない2つの点
どのウィンドウ設定が却下を決めたのか。議長らの投稿のTable 3によれば、中ウィンドウでは12.7%(約123本)、標準ウィンドウでは42.7%(約414本)が≥90%だった。判定表であるTable 5は、追加条件なしで≥0.9の77本を即時却下している[1]。表面上、77はどちらの数とも一致せず、投稿はTable 5がどのスコアを用いたかを述べていない。別のスコア定義や後の除外など、単純な説明があるのかもしれないが、投稿には書かれていない。どのスコアに適用されたか分からない閾値を、著者は確かめることができない。
査読者の側。同じ方針は査読者に「レビューの執筆にAIツールを使わないと誓約する」ことを求めていた[1]。投稿はすべての投稿論文を審査したことを説明しているが、レビューを審査したという説明はない。強制のない誓約がどの程度守られるかの参考として、ICML 2026のランダム化実験では、LLM禁止の方針に割り当てられた査読者の22.5%が、アンケートでそれでもLLMを使ったと答えた[9]。別の会議であり、NeurIPSの査読者について直接何かを示すものではない。ただ、議長らが著者には不十分と判断した誓約に、査読者については依拠していることを示している。
7. まだ公表されていないこと
- 条件付きの123本のうち何本が資料を提出し、何本が認められ、何本が取り下げたか。
- 9月24日にトラックが何本のポジションペーパーを採択したか。
- Table 5の閾値がどのウィンドウ設定とスコア定義を用いたか。
- 即時却下された著者が、自分のスコアと文章のウィンドウ分割を示されたかどうか。
- 非ネイティブ著者による形式的な学術文章でのv3.3.2の較正。Pangramによるものでも、他の誰によるものでも。
議長らがこれらのいずれかを公表すれば、本稿を更新する。影響を受けた著者で、通知の文面や異議の結果などの一次資料を共有してもよいという方は、[email protected]まで連絡してほしい。検証できないものは掲載しない。
8. 当事者である場合、または次のサイクルに投稿する場合
この却下は通常の即時却下として説明されている。議長らの投稿は「a standard desk-rejection」という表現を使い[1]、これを研究不正の認定とは説明していない。論文がNeurIPSで審査中でなくなれば、他所への投稿には通常のルールが適用される。新しい投稿先の二重投稿とAI利用の規定を確認してほしい。
具体的に申告すること。22本の区分には、AI不使用と申告した著者と何も申告しなかった著者の両方が含まれていた。空欄の申告は否定と同じに扱われた。
バージョン履歴を残すこと。議長らが求めた資料は、AI使用前のチェックポイント、AI使用後のチェックポイント、最終論文、そしてAIによる修正が新たな実質的内容を加えていないことを示す分析だった[1]。彼らは「今後はこの種の監査記録が標準になると予想する」と書いている。Overleafの履歴、Gitのコミット、Googleドキュメントの版の履歴は、作業しながらこれを自動的に残してくれる。後から作るのは非常に難しい。
ツールに関する証拠を知っておくこと。我々が見つけた唯一の統制実験では、Grammarlyによる全面的な修正でPangramの「AI」判定は1件も出なかった。レビュー全体の機械翻訳では1.1–4.5%の割合で「AI」判定が出た[5]。いずれも論文ではなくレビュー程度の長さの文章での小規模な検証である。
検出器に代わる手段にも注目すること。提案の1つであるgreCAPTCHA(Payan、Gyevnár、Kasirzadeh、Shah、9月17日)は、文章を採点する代わりに、名前を連ねた著者が自分の論文を理解しているかを検証する。試作版は研究者31名を対象に、実際の著者かどうかをAUC 0.90で予測した[10]。小規模な試作であり、我々の知る限り採用している会議はない。
9. 引用チェックにできること、できないこと
StrictCiteはAIによる文章を検出しない。本稿のどの部分も、Pangramではなく我々の製品を使えという主張ではない。両者は別の問いに答える。Pangramは誰が文を書いたかを推定し、4節と5節で見たように、開発元自身のベンチマークでさえ不確かさは「推敲された中間領域」にある。参考文献はCrossref、OpenAlex、DBLPの実在する記録に結びつくか、結びつかないかのどちらかであり、その答えは自分で確かめられる。それが今回のNeurIPSにおけるもう1つの即時却下の仕組みであり[12]、投稿前に完全に自分で確認できるほうである。参考文献リストはstrictcite.comで無料でチェックできる。