1. Was sich am 24. September geändert hat und was nicht
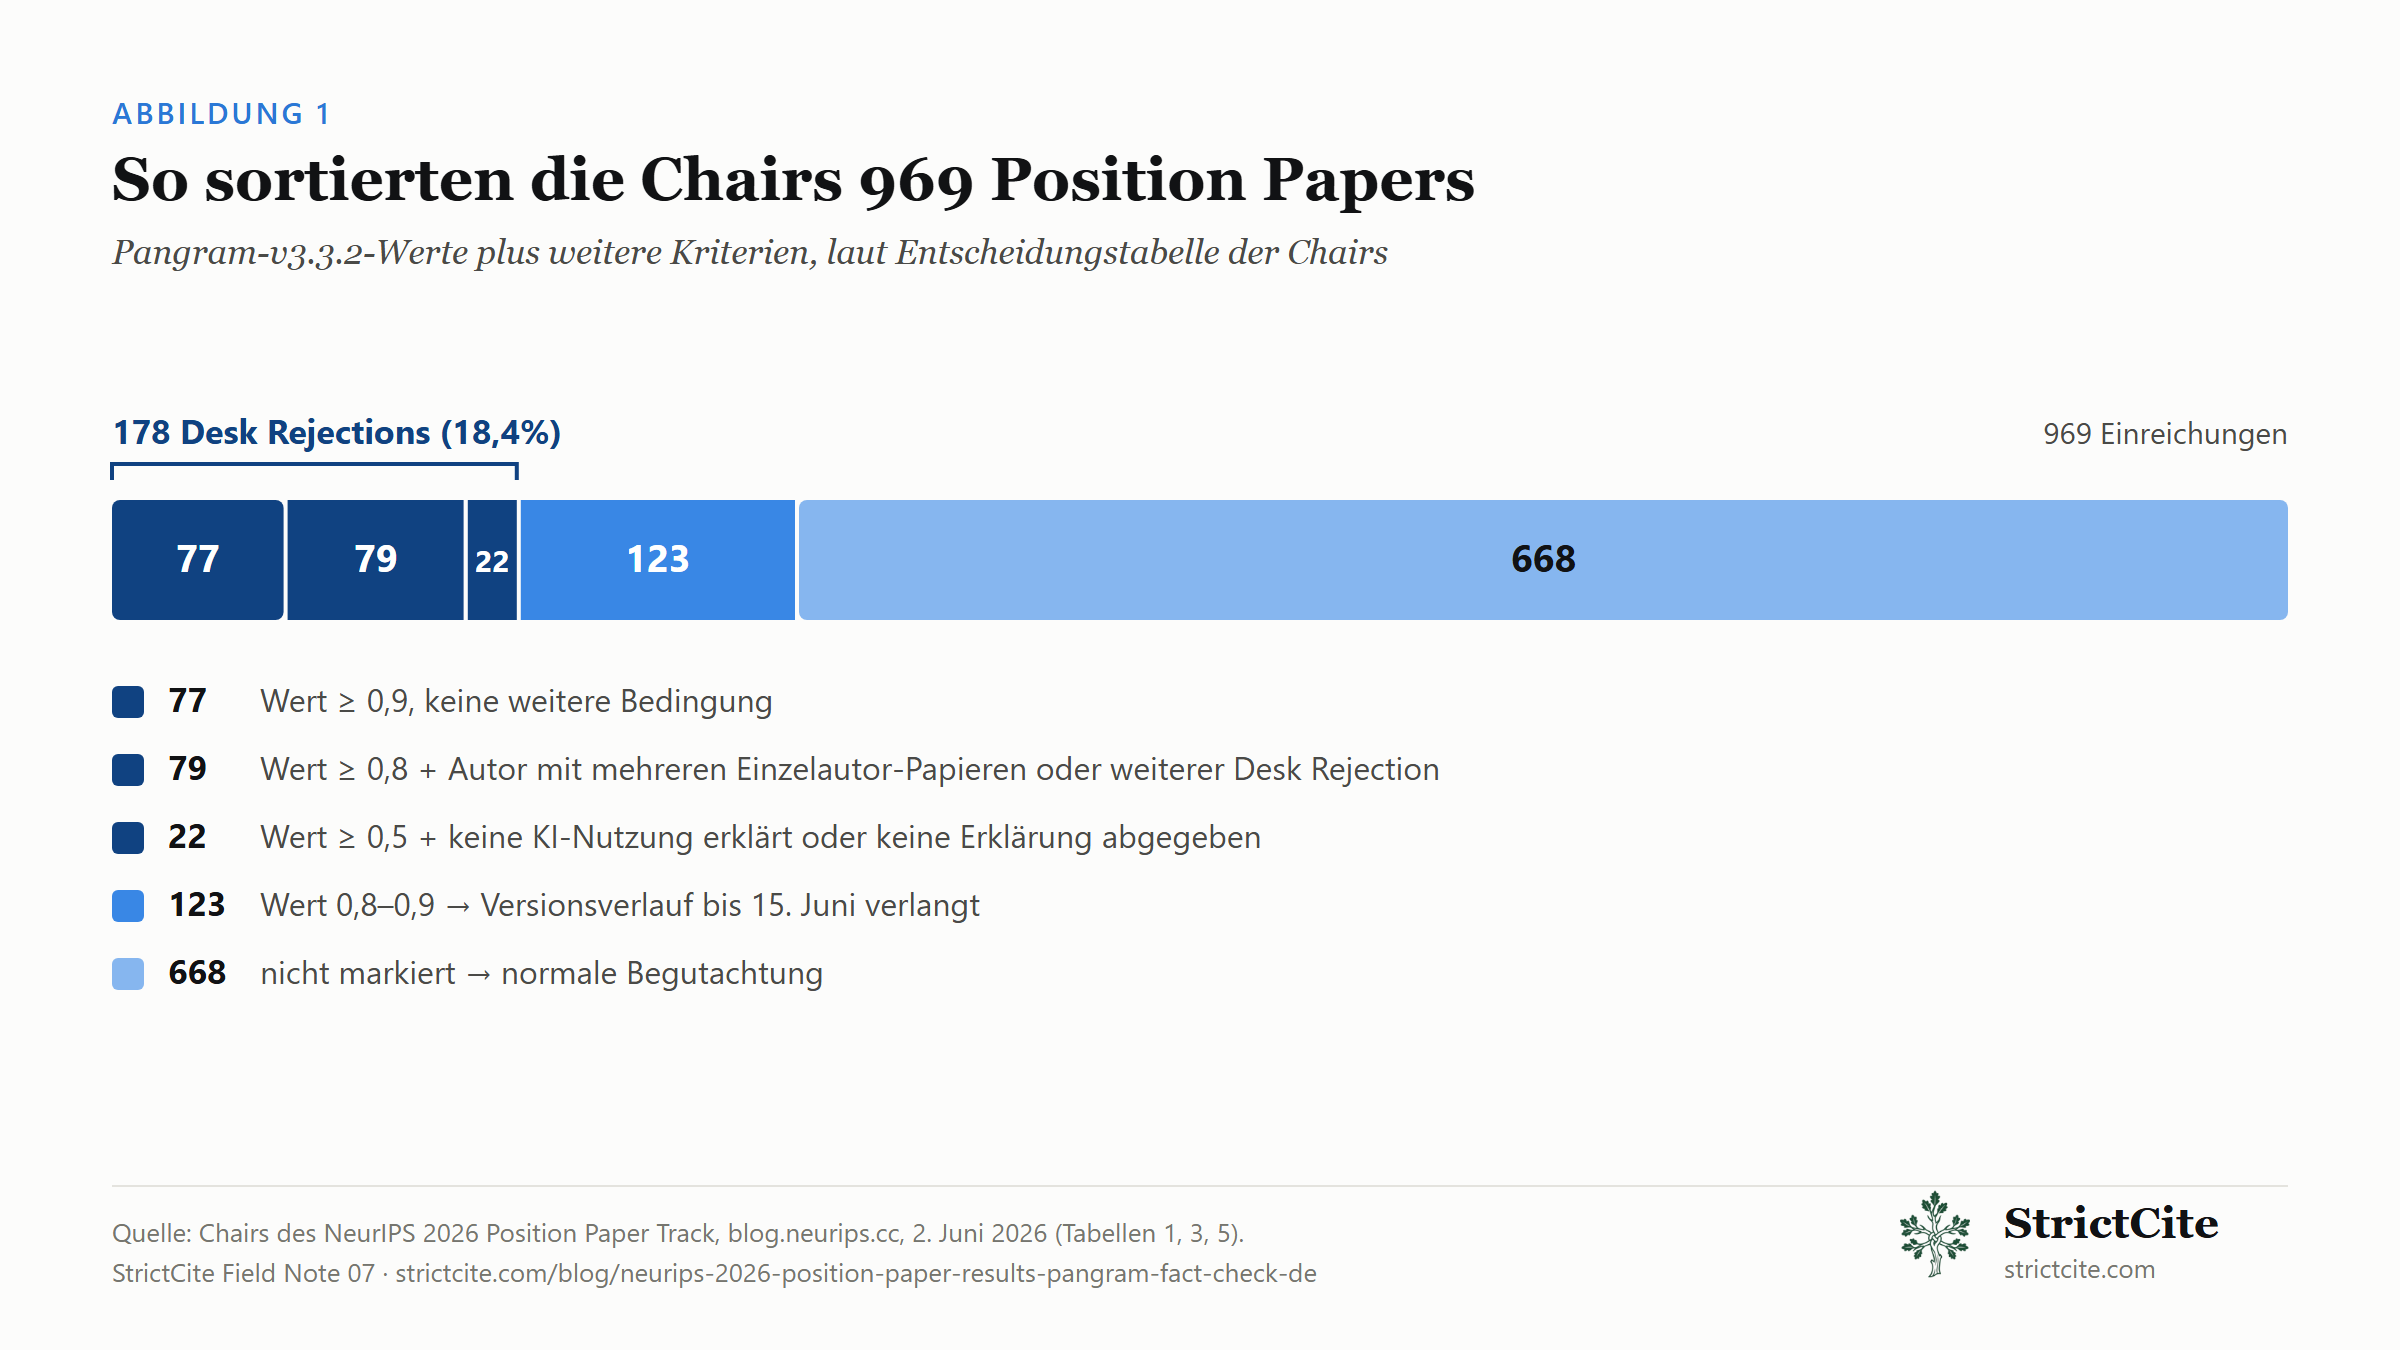
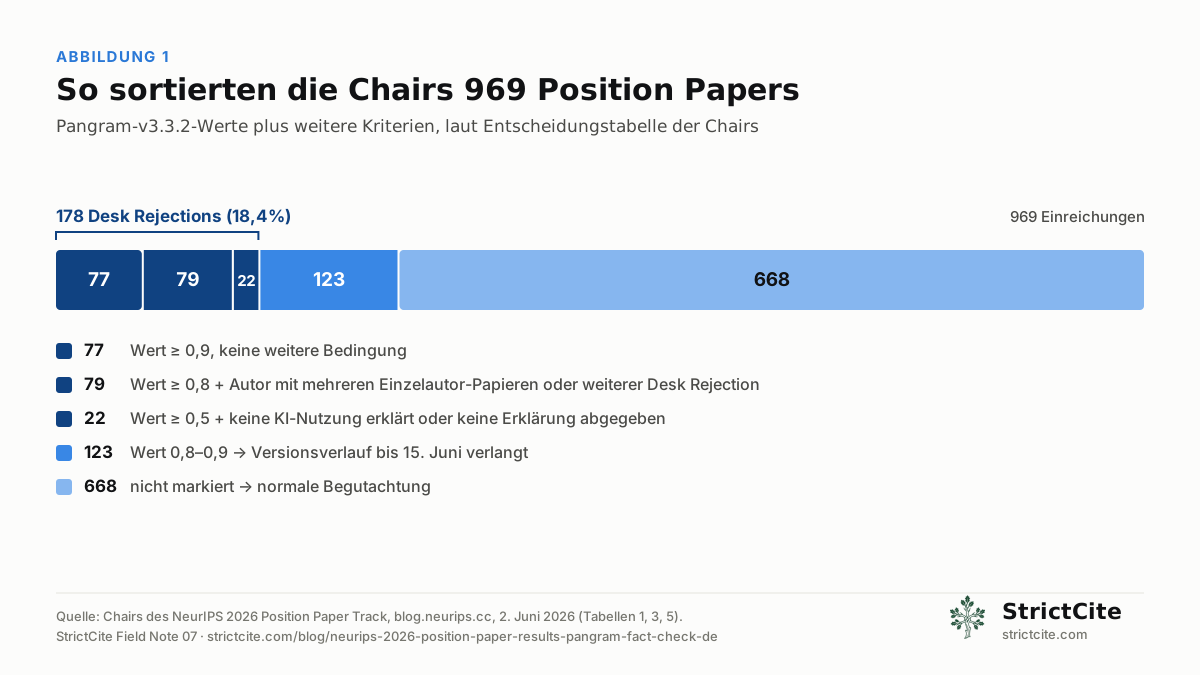
Der Call for Papers des Position Paper Tracks nennt den 24. September als Datum der finalen Entscheidungen[2]. An diesem Tag erfuhren die verbliebenen Einreichungen, ob sie angenommen wurden. Es ist nicht die Frist für die 123 bedingt markierten Papiere. Deren Autoren hatten bis zum 15. Juni Zeit, ein Dossier mit Versionsverlauf vorzulegen, sonst folgte die Desk Rejection[1].
Unverändert ist die öffentliche Faktenlage. Stand 26. September betreffen die neuesten Beiträge im NeurIPS-Blog Affinity-Events (25. September) und finanzielle Unterstützung (16. September)[3]. Der Beitrag der Chairs vom 2. Juni hat keinen Nachtrag. Nirgends ist öffentlich, wie viele der 123 Dossiers anerkannt wurden, wie viele Autoren zurückzogen oder wie viele Position Papers der Track am Ende annahm. Jede Zahl, die du dazu siehst, stammt nicht von NeurIPS, und wir haben keine mit Quelle gefunden.
2. Zwölf Behauptungen, geprüft
Das sind die Behauptungen, die wir rund um das Entscheidungsdatum in Beiträgen und Zusammenfassungen am häufigsten gesehen haben, auch in unserem eigenen früheren Text. Jedes Urteil beruht auf der Quelle, die in derselben Zeile verlinkt ist.
| Behauptung | Was die Primärquelle sagt | Urteil |
|---|---|---|
| Der 24. Sept. war das finale Ablehnungsdatum für die 123 bedingten Papiere. | Die Nachweisfrist war der 15. Juni[1]. Der 24. Sept. ist das Datum der finalen Entscheidungen für den ganzen Track[2]. | Falsch |
| Einsprüche scheiterten, wenn große Textblöcke in einzelnen Commits auftauchten oder Autoren Grammarly bzw. DeepL angaben. | Keine Quelle gefunden. Dossiers werden „vom PPT-Team geprüft“[1], Ergebnisse sind nicht öffentlich. Unabhängig davon ergab ein kontrollierter Test für Grammarly-Korrekturen 0 von 100 „KI“-Urteilen von Pangram[5]. | Nicht überprüft |
| 79 Papiere wurden wegen Wert über 0,8 und Alleinautorschaft abgelehnt. | Das Kriterium ist Wert ≥0,8 plus entweder ein Autor, der „mehrere Papiere in Alleinautorschaft eingereicht hat, mindestens eines über der Schwelle“, oder ein Autor mit „mindestens einer weiteren Desk Rejection“[1]. Alleinautorschaft allein löst es nicht aus. | Falsch (haben wir auch geschrieben) |
| 22 Papiere wurden abgelehnt, weil sie über 0,5 lagen, nachdem der Autor jede KI-Nutzung verneint hatte. | Das Kriterium ist Wert ≥0,5, wenn der „Autor erklärte, keine KI genutzt zu haben, oder keine KI-Nutzung angab“[1]. Es erfasst auch Autoren, die die Erklärung leer ließen. | Unvollständig (haben wir auch geschrieben) |
| Gegen die 178 Desk Rejections gab es keinen Einspruch. | „Eine normale Desk Rejection, die unter normalen Umständen nicht anfechtbar ist“[1]. Die 123 sind als „Desk Reject with Appeal“ geführt. | Stimmt, mit Einschränkung |
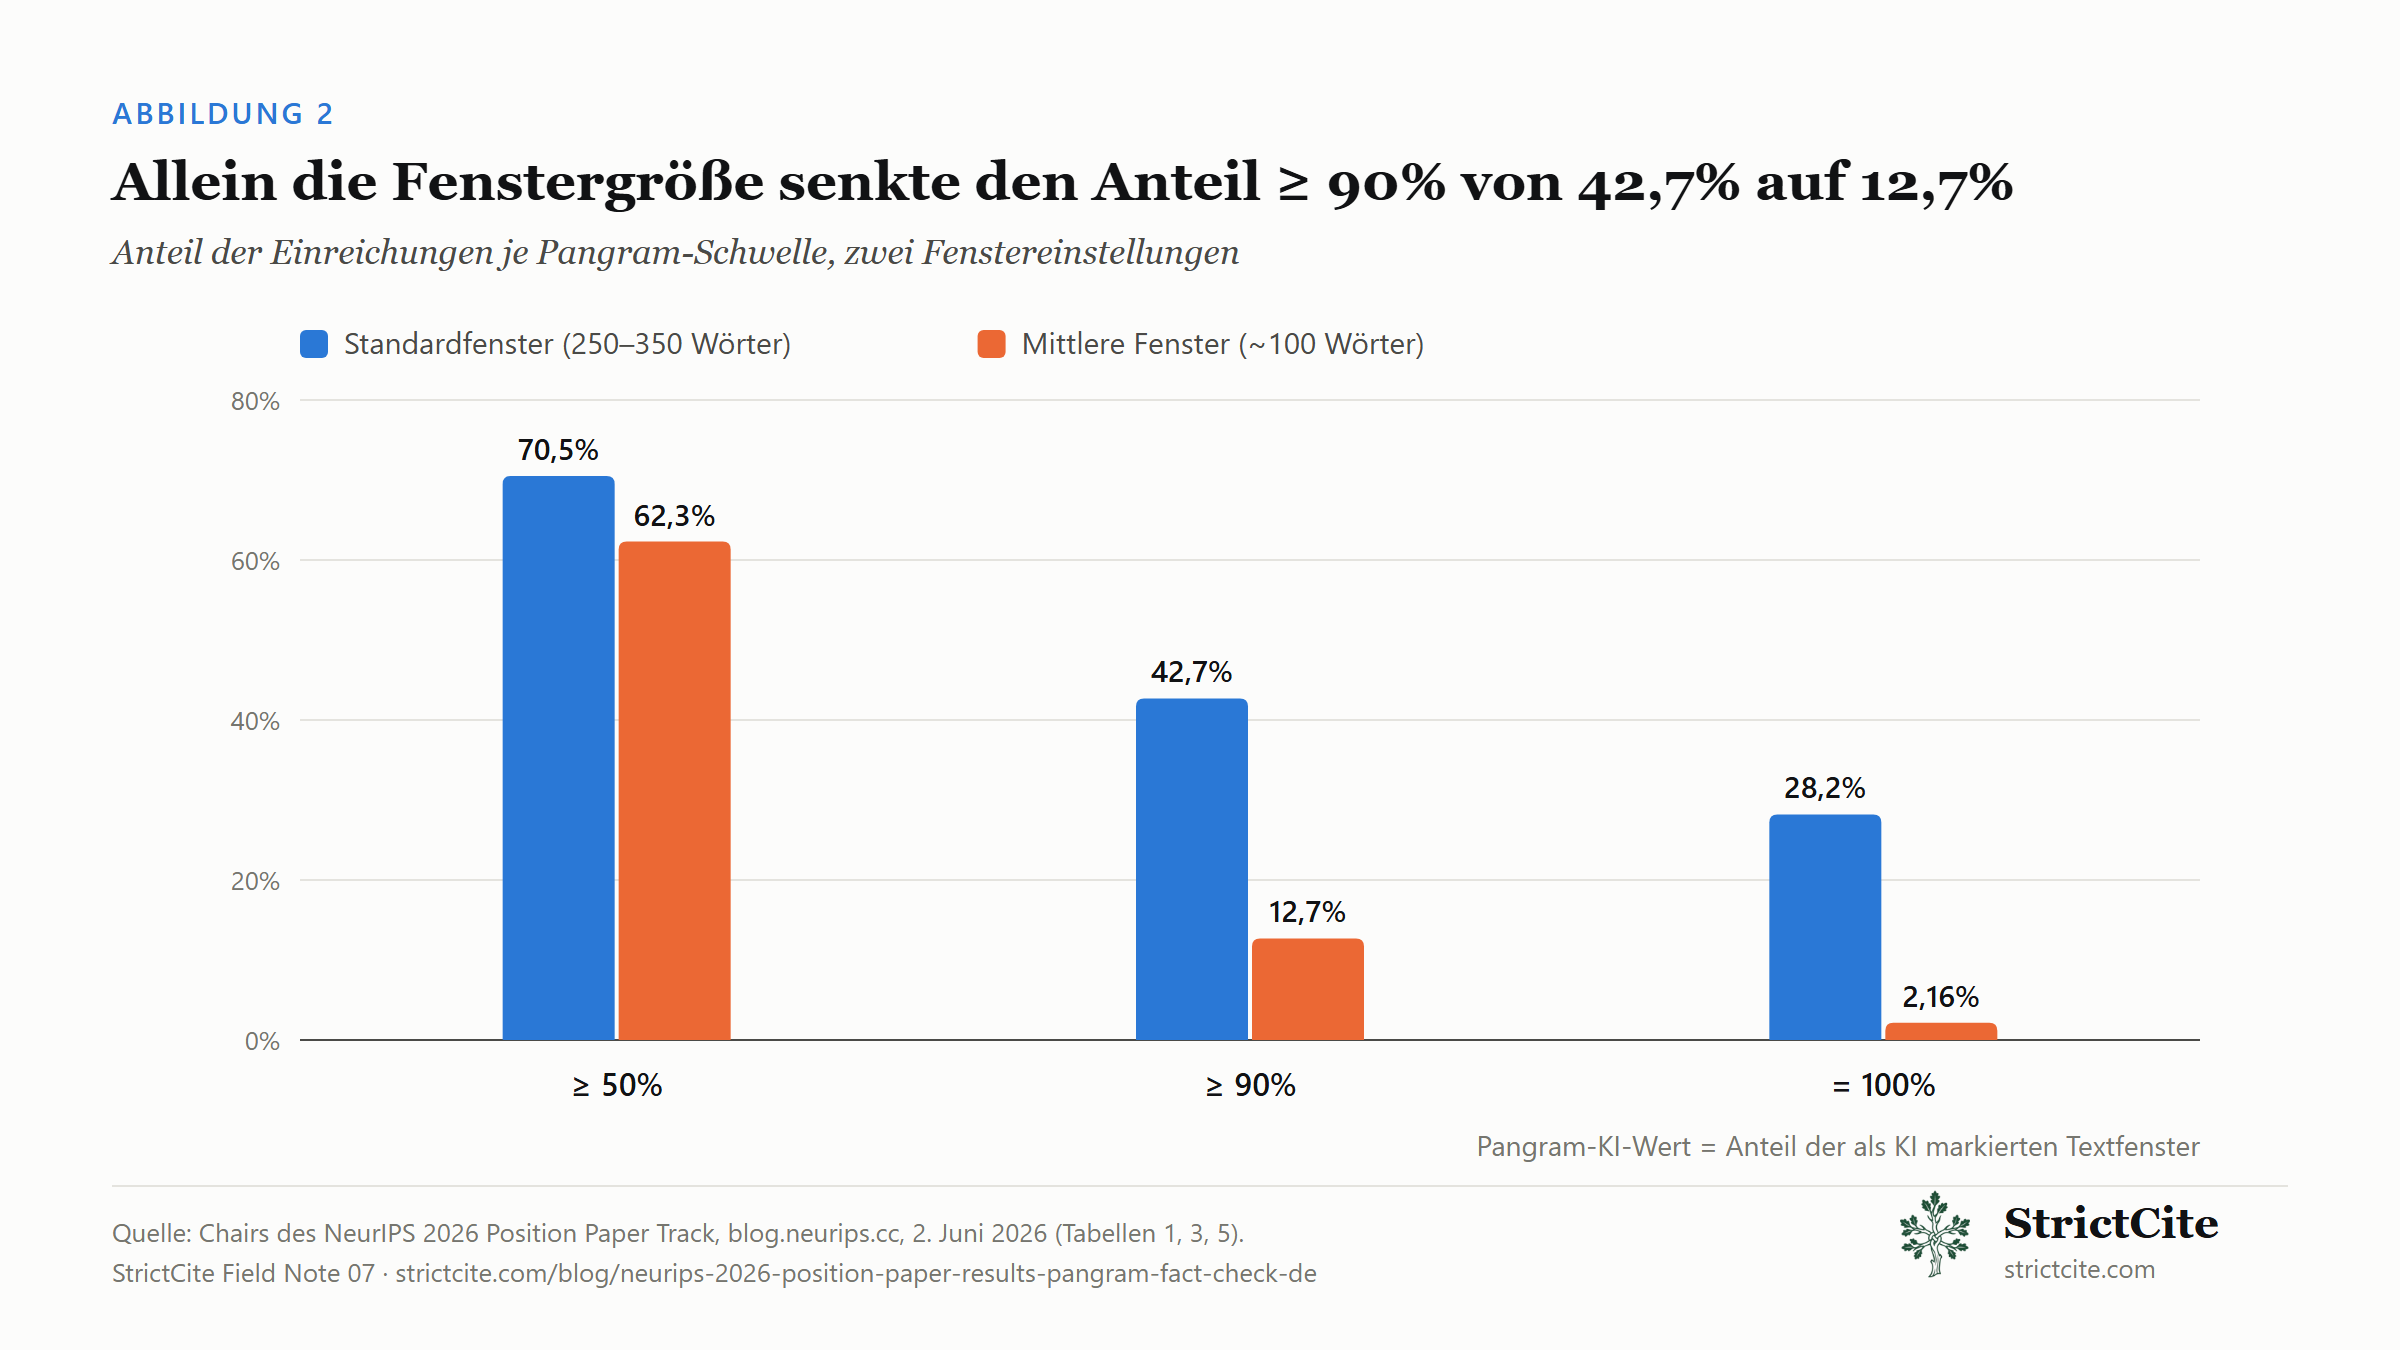
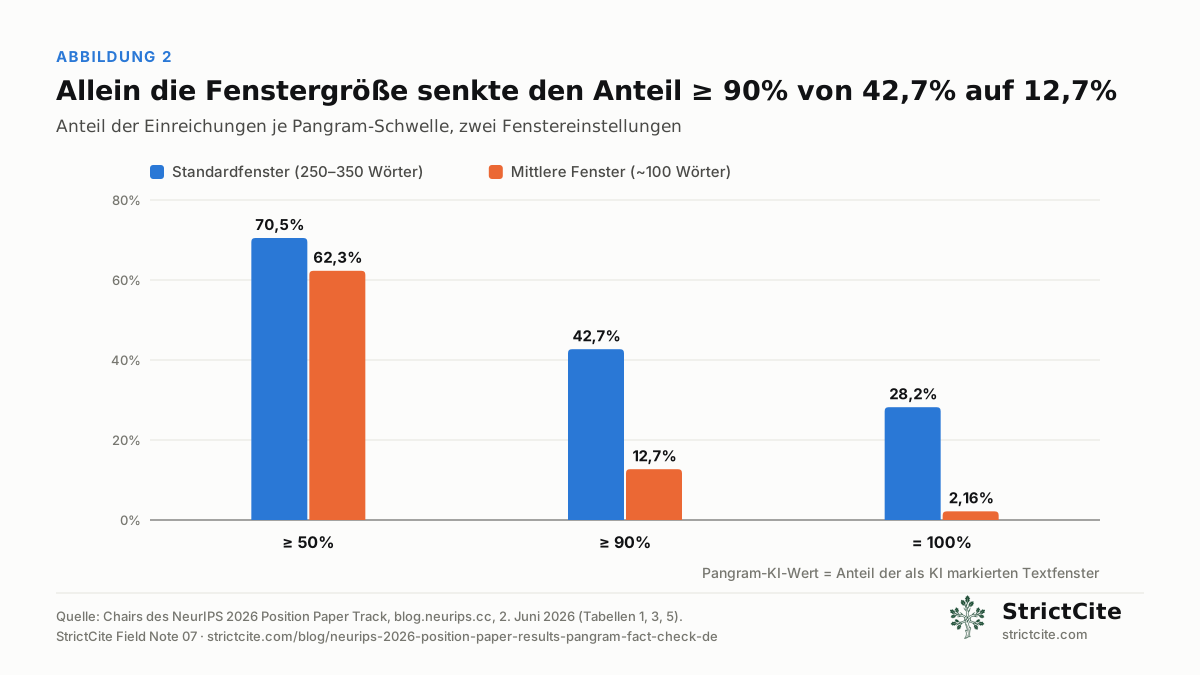
| Bei Standardfenstern von 250–350 Wörtern erreichten 42,7% der Einreichungen 90–100% KI. | Tabelle 1 und 3 im Beitrag der Chairs: 42,7% ≥90%, 28,2% bei 100%, 70,5% ≥50%[1]. | Stimmt |
| Die Chairs verkleinerten die Fenster auf 100 Wörter, um die Quote zu drücken. | Die Zahlen stimmen: 42,7% fielen auf 12,7% bei ≥90%. Das Motiv ist nicht das, das die Chairs nannten. Sie sagten, kleinere Fenster verringerten das „Überschätzen der KI-Nutzung“, und veröffentlichten den damit verbundenen Verlust an Recall (Tabelle 2)[1]. | Zahlen stimmen, Deutung nicht |
| Unabhängige Forscher ließen die Papiere der Chairs durch Pangram laufen und erhielten 24%, 36%, 45% und 69%. | Eine Person: Sergey Berezin, in einem LinkedIn-Beitrag vom 3. Juni. Er nannte die vier Papiere und schrieb: „Ich behaupte ausdrücklich nichts über den Entstehungsprozess dieser Papiere“[6]. Sein Beitrag sagt nicht, dass sein eigenes Papier abgelehnt wurde. | Stimmt, eine Quelle (wir haben seinen Status übertrieben) |
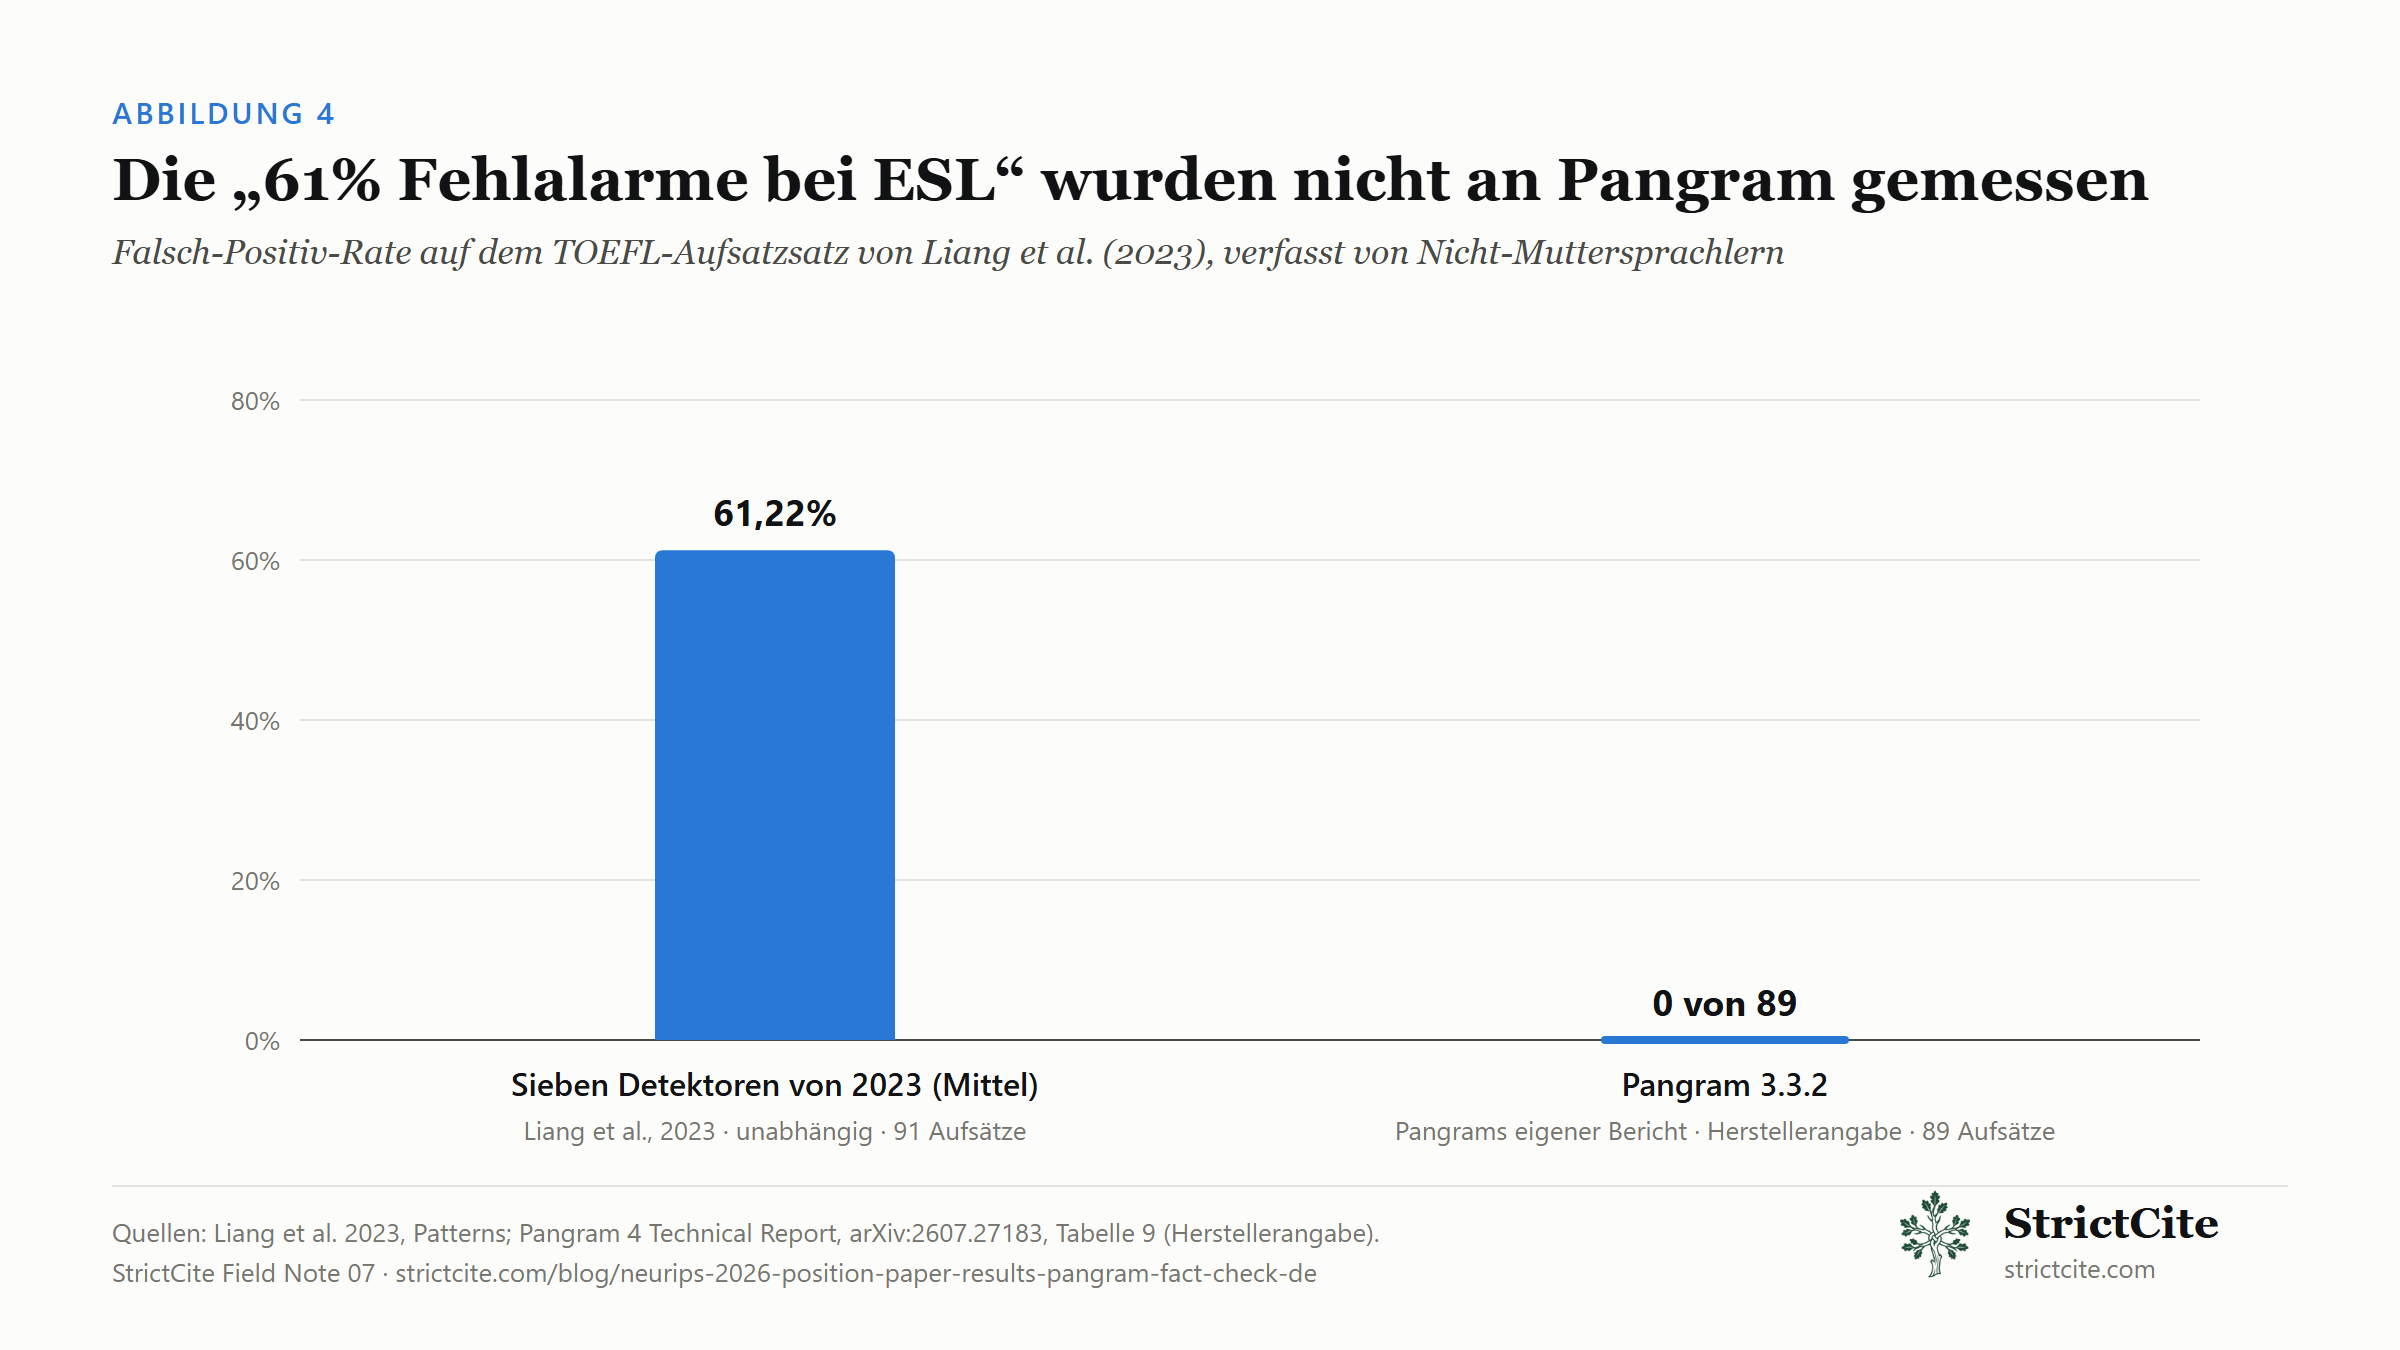
| Pangram benachteiligt Nicht-Muttersprachler. Stanford fand 61,22% Fehlalarme bei TOEFL-Aufsätzen. | Die 61,22% stammen von Liang et al. (2023), die sieben andere Detektoren testeten[7], nicht Pangram. Auf denselben TOEFL-Aufsätzen meldet Pangrams eigener Bericht für v3.3.2 0 Falsch-Positive von 89[4]. Das sind Herstellerdaten, nicht unabhängig repliziert. | Falsch in Bezug auf Pangram |
| In einem anderen NeurIPS-Track stieg die KI-Nutzung um mehr als das Zehnfache. | In Evaluations & Datasets stieg der Anteil der Papiere mit ≥90% von 0,8% (2025) auf 9,3% (2026)[1]. | Stimmt |
| Substack führte Pangram für zahlende Abonnenten ein und prägte „Claudefishing“. | Chris Best prägte den Begriff am 21. Juli. Der Scan läuft bei Texten über 100 Wörter und „zeigt eine Analyse nur denen, die sie anfordern“[8]. Bests Beitrag beschränkt ihn nicht auf zahlende Abonnenten. | Teilweise falsch |
| Die Community mobilisierte den ganzen September über in riesigen Reddit-Threads. | Wir fanden keinen konkreten Thread, den wir zitieren könnten, und wiederholen es daher nicht. | Nicht überprüft |
3. Was wir am 8. September falsch hatten
Unsere frühere Field Note[11] enthielt vier Fehler. Wir haben die Seite heute korrigiert und als aktualisiert markiert. Wir führen sie hier auf, weil dieser Text anderen dieselben Fehler vorhält:
- Wir schrieben, die 79er-Stufe sei „Wert über 0,8 + Alleinautorschaft“. Das tatsächliche Kriterium steht in der Tabelle oben.
- Wir schrieben, die 22er-Stufe setze eine ausdrückliche Verneinung von KI-Nutzung voraus. Sie erfasst auch Autoren ohne Erklärung.
- Wir nannten Sergey Berezin „einen abgelehnten Autor“. Sein Beitrag sagt das nicht.
- Wir schrieben Gutachterbeschwerden über „Claude-Sprech“ seinem Beitrag zu. Wir finden die Formulierung in der zitierten Quelle nicht und haben sie entfernt.
4. Was Pangrams eigener Bericht über die von NeurIPS genutzte Version sagt
Die Chairs prüften den Track mit Pangram v3.3.2[1]. Am 29. Juli veröffentlichte Pangram Labs den technischen Bericht zu v4 auf arXiv[4], und fast jede Tabelle darin vergleicht v4 mit 3.3.2. Soweit wir wissen, ist das der einzige veröffentlichte Benchmark des Modells, das den Track geprüft hat. Es sind Herstellerdaten, gemessen auf vom Hersteller gewählten oder selbst ausgeführten Benchmarks, nicht auf Position Papers. Mit dieser Einschränkung lauten die Zahlen:
| Maß (Pangrams eigener Bericht) | v3.3.2 | v4 | Stelle |
|---|---|---|---|
| Falsch-Positive, über 1 Mio. menschlich verfasster englischer Texte | 0,0539% | 0,0041% | §5.3 |
| Falsch-Negative, 520.000 KI-Texte | 1,99% | 0,34% | §5.2 |
| Falsch-Positive, 24.586 Texte von Englischlernenden | 2 (0,0081%) | 1 (0,0041%) | Tabelle 9 |
| … davon TOEFL-Aufsätze von Liang et al. (n=89) | 0 | 0 | Tabelle 9 |
| KI-polierter Text als „KI“ eingestuft (n=11.363) | 0,18% | 0,01% | Tabelle 4 |
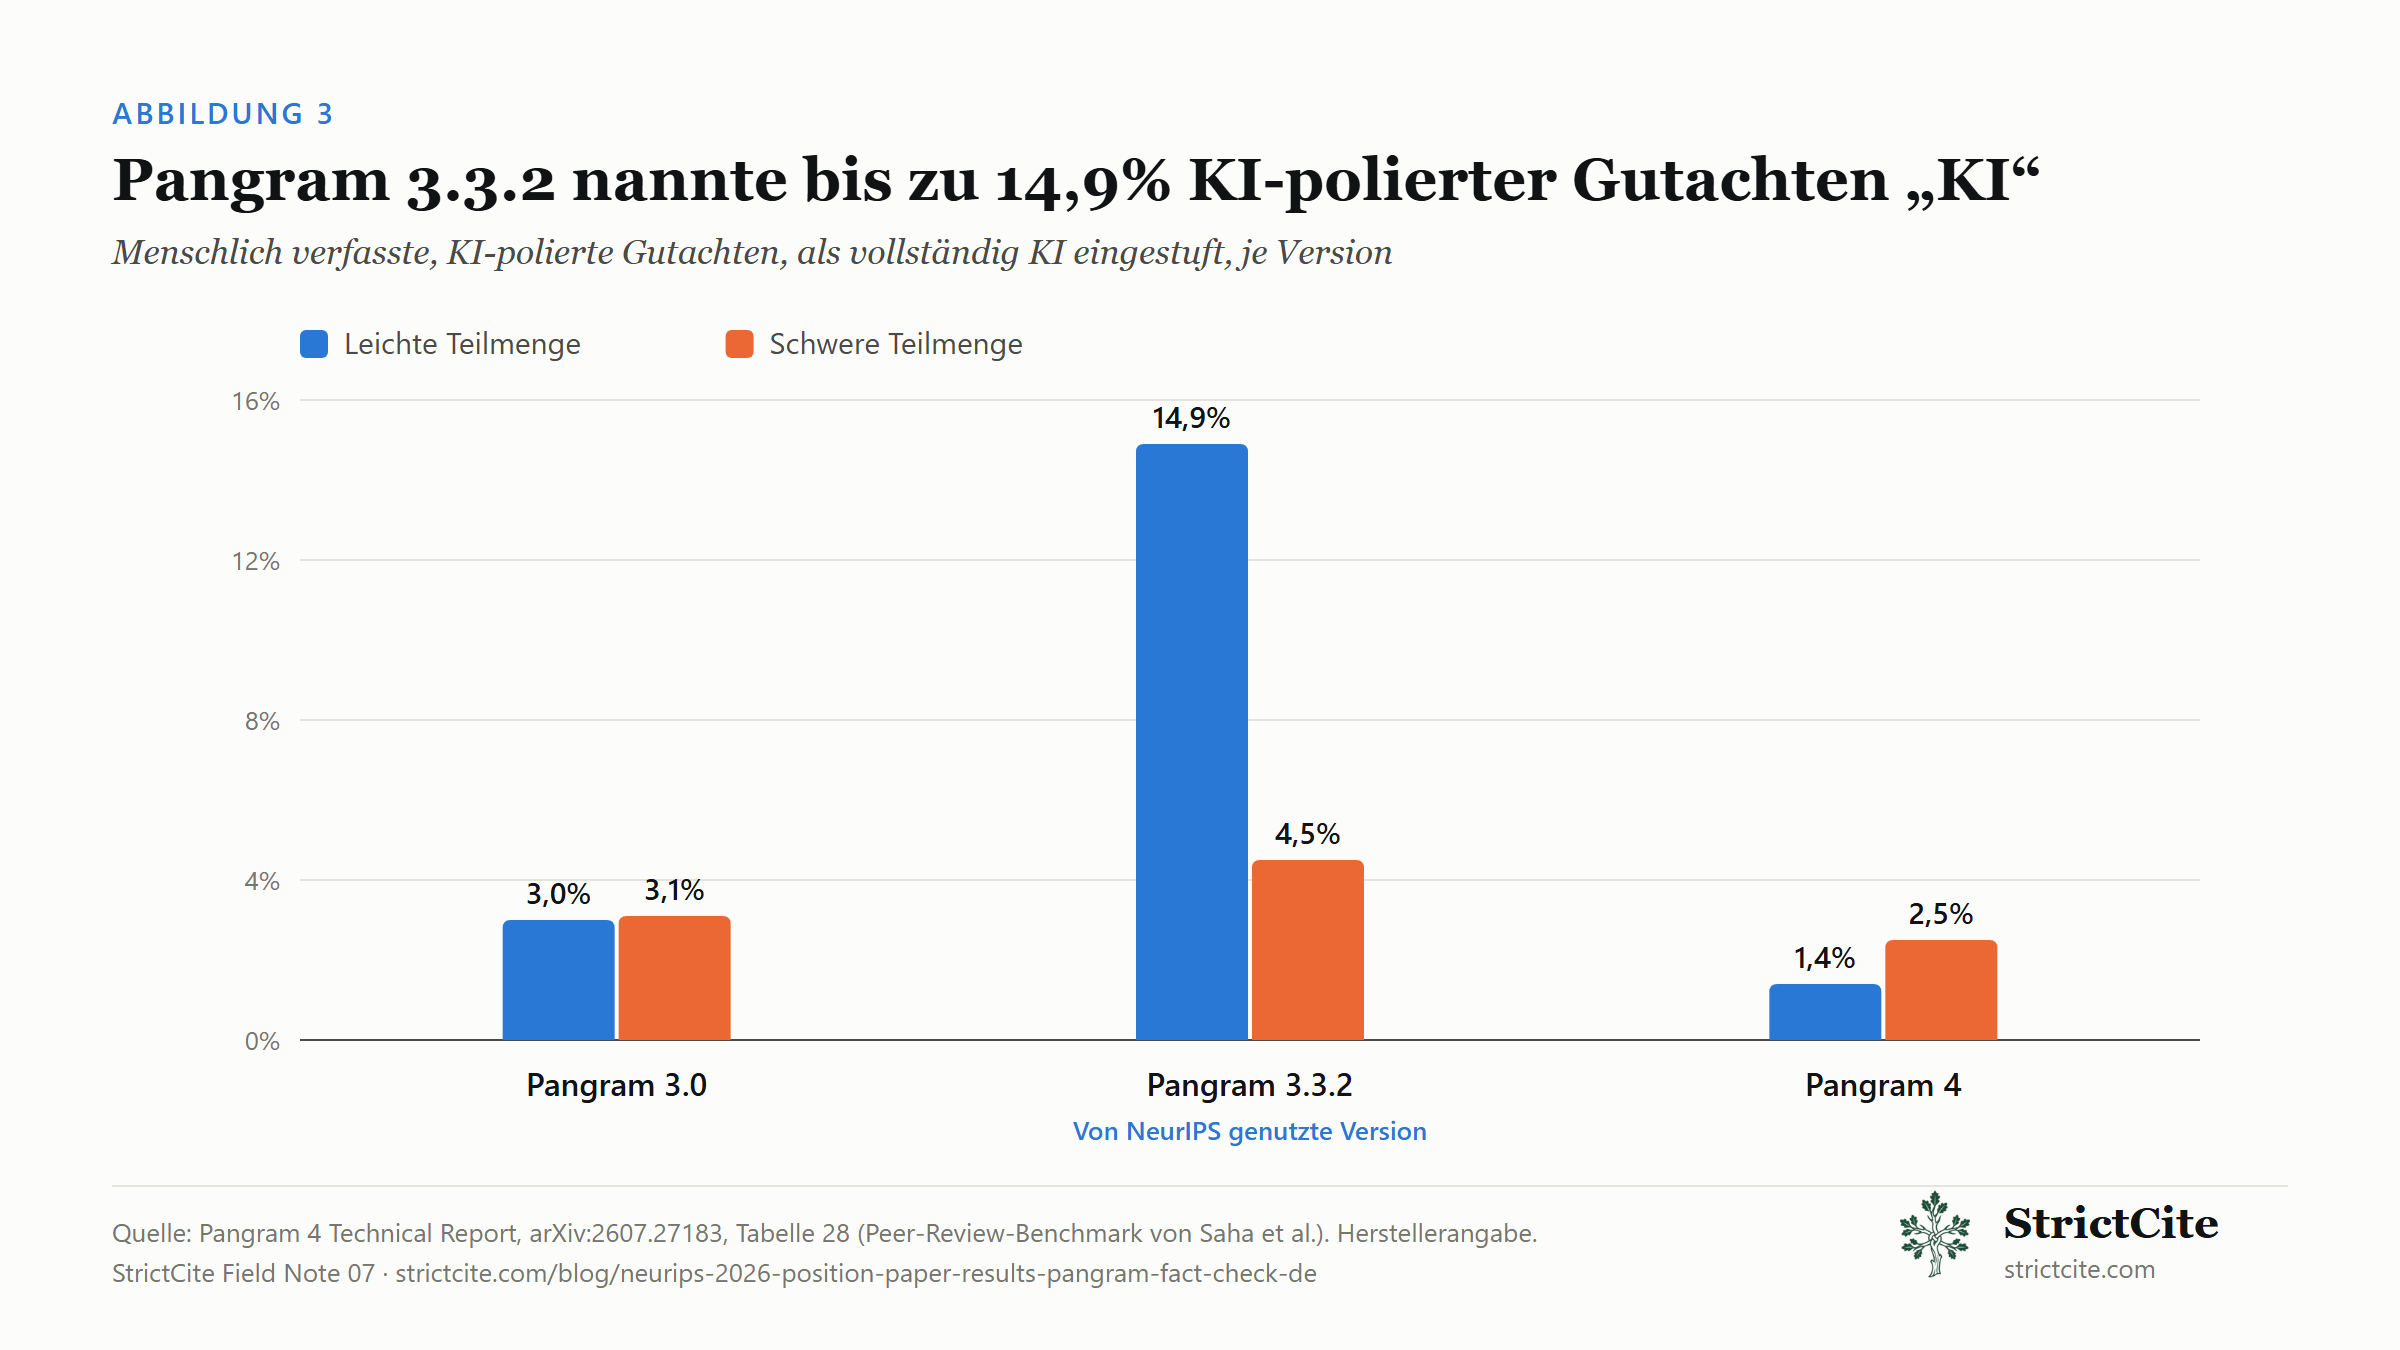
| KI-polierte menschliche Gutachten als „KI“ eingestuft, leichte / schwere Teilmenge | 14,9% / 4,5% | 1,4% / 2,5% | Tabelle 28 |
| Stark KI-bearbeiteter Text korrekt als „Mixed“ eingestuft (n=14.990) | 5,54% | 55,01% | Tabelle 5 |
| Mittlerer Fehler beim geschätzten KI-Anteil, gemischte Dokumente | 28,6 Pkt. | 5,9 Pkt. | Tabelle 7 |
Wir lesen daraus drei Dinge, und das erste widerspricht der Kritik, über die wir früher berichtet haben.
Rein menschlicher Text ist nicht das Risiko. Bei der für v3.3.2 berichteten Falsch-Positiv-Rate von 0,0539% wären über 969 Papiere etwa 0,5 Fehlalarme zu erwarten, wenn sich Position Papers wie die Testdaten des Herstellers verhalten. Das hat niemand gezeigt. Aber wenn die Zahl auch nur ungefähr stimmt, können Fehlalarme bei vollständig menschlich geschriebenen Papieren keine Ablehnungsquote von 18,4% erklären. Die Erklärung muss mit KI zu tun haben: entweder KI-Entwürfe oder das KI-Polieren, das die Regeln erlauben.
Die ESL-Behauptung, wie sie meist formuliert wird, passt nicht zu Pangrams Daten. Auf genau den TOEFL-Aufsätzen, die bei anderen Detektoren die viel zitierten 61,22% ergaben, hatte v3.3.2 null Fehlalarme. Der Bericht zeigt allerdings, dass der Hersteller diese Fälle als die schwierigen behandelt. Bei der Beschreibung eines verworfenen Trainingsdesigns heißt es, die Fehler hätten sich „in bestimmten Registern konzentriert: akademisches Schreiben und ESL-Aufsätze“[4]. Einen unabhängigen Test von v3.3.2 an akademischen Texten nicht-muttersprachlicher Autoren haben wir nicht gefunden.
Bei poliertem menschlichem Text war v3.3.2 am schwächsten. Bei menschlich verfassten Gutachten, die anschließend von einer KI poliert wurden, stufte v3.3.2 14,9% der leichten Teilmenge als vollständig „KI“ ein. Das ist das Zehnfache von v4 auf derselben Teilmenge. Die Zeile, die der Bericht mit Pangram 3.0 beschriftet, zeigt 3,0%; die von NeurIPS genutzte Version schnitt hier also schlechter ab als Vorgänger und Nachfolger. Der Bericht nennt das Verhalten von 3.3.2 bei gemischtem Text außerdem „polarisiert“: KI-unterstützte Texte werden lieber als Human oder KI statt als Mixed eingestuft. Genau diese Kategorie erlauben die Regeln des Tracks ausdrücklich („Lektorat oder ähnliche periphere Änderungen“[1]). Die Chairs haben das getestet: Bei 100-Wort-Auszügen aus 10 FAccT-2022-Papieren wurde keine der erlaubten Bearbeitungen markiert, die sie ausprobierten[1]. Zehn Stichproben sind ein kleiner Test neben der Herstellerzahl aus einem größeren Benchmark.
5. Das ICML-Paper, das die Ablehnungen namentlich behandelt
Das Paper Policies Permitting LLM Use for Polishing Peer Reviews Are Currently Not Enforceable von Saha, Juneja, Chaudhuri, Sajeevan, Shah und Pruthi erscheint auf der ICML 2026[5]. Es ist die sorgfältigste Quelle, die wir gefunden haben, und sein Fazit ist differenzierter als beide Seiten des Streits. Der Hauptbefund: Alle fünf getesteten Detektoren „stufen einen nicht unerheblichen Anteil LLM-polierter Gutachten fälschlich als KI-generiert ein“. Pangram stufte 3,1% der KI-polierten menschlichen Gutachten als „KI“ ein, nicht einmal als „Mixed“. Im Anhang:
- Grammarly: Nachdem bei 100 menschlichen Gutachten jede Grammarly-Korrektur angenommen wurde, lieferte Pangram 89-mal „Human“, 11-mal „Mixed“ und 0-mal „KI“.
- Maschinelle Übersetzung: Nach einem Hin- und Rückweg über Deutsch, Chinesisch oder Japanisch mit Google Translate und DeepL stufte Pangram 1,1% bis 4,5% der Gutachten als vollständig „KI“ ein, je nach Sprache und Reihenfolge der Übersetzer.
- Polieren mit Stilvorgaben („britisches Englisch“, „kurze Sätze“): 2,42% als „KI“ eingestuft.
Das Übersetzungsergebnis ist wichtig für alle, die in einer anderen Sprache entwerfen. Die Regeltabelle der Chairs stuft „Übersetzung / Rückübersetzung“ als grenzwertig zulässig ein[1].
Zu NeurIPS stellen die Autoren klar, dass ihre Zahlen nicht beweisen, dass die Ablehnungen falsch waren:
„Unsere Falsch-Positiv-Rate von ca. 3% bei KI-polierten (H-AI) Gutachten ist am besten als Rate pro Fenster zu verstehen, nicht pro Papier … Wären die Falsch-Positiv-Raten der Fenster unabhängig, wäre es unwahrscheinlich, dass bei einem nur mit LLMs polierten Papier mehr als 50% der Fenster markiert werden … Eine zentrale Einschränkung ist jedoch, dass diese Überlegung Unabhängigkeit zwischen Fenstern desselben Papiers voraussetzt. Der individuelle Schreibstil eines Autors kann korrelierte Fehler über Fenster hinweg erzeugen … Falsch-Positiv-Raten pro Fenster sollten daher in keine Richtung auf ganze Papiere hochgerechnet werden.“[5]
Wir haben das Argument mit der schlechteren Rate von v3.3.2 nachgerechnet. Würde jedes Fenster eines nur polierten Papiers unabhängig mit 14,9% markiert, läge die Wahrscheinlichkeit, dass mehr als die Hälfte eines Papiers mit 30 Fenstern markiert wird, bei etwa eins zu einer Million. Alles hängt an der Unabhängigkeitsannahme. Sie besagt, dass der Stil eines Autors von Absatz zu Absatz keine Rolle spielt, obwohl gerade ein beständiger Stil einen Text wiedererkennbar macht. Niemand hat das gemessen. Am stärksten betroffen ist die 22er-Stufe, deren Schwelle bei 0,5 statt 0,8 oder 0,9 liegt.
6. Zwei Dinge im Beitrag der Chairs, die wir nicht in Einklang bringen konnten
Welche Fenstereinstellung über die Ablehnungen entschied. Laut Tabelle 3 im Beitrag der Chairs erreichten mit mittleren Fenstern 12,7% der Papiere (etwa 123) ≥90%, mit Standardfenstern 42,7% (etwa 414). Tabelle 5, die Entscheidungstabelle, lehnt bei ≥0,9 ohne weitere Bedingung 77 Papiere ab[1]. Auf den ersten Blick passt 77 zu keiner der beiden Zahlen, und der Beitrag sagt nicht, welche Werte Tabelle 5 verwendete. Vielleicht gibt es eine einfache Erklärung, etwa eine andere Wertdefinition oder spätere Ausschlüsse, aber sie steht nicht im Beitrag. Autoren können eine Schwelle nicht nachprüfen, wenn sie nicht wissen, auf welchen Wert sie angewendet wurde.
Die Gutachterseite. Dieselben Regeln verlangten von Gutachtern, „sich zu verpflichten, keine KI-Tools zum Schreiben ihrer Gutachten zu nutzen“[1]. Der Beitrag beschreibt die Prüfung jeder Einreichung, aber keine Prüfung der Gutachten. Zur Einordnung, wie gut eine Verpflichtung ohne Durchsetzung hält: In einem randomisierten Experiment auf der ICML 2026 gaben 22,5% der Gutachter mit LLM-Verbot in einer Umfrage an, trotzdem ein LLM genutzt zu haben[9]. Das ist eine andere Konferenz und sagt nichts direkt über NeurIPS-Gutachter. Es zeigt aber, dass die Erklärung, die die Chairs bei Autoren für unzureichend hielten, bei Gutachtern die Grundlage bleibt.
7. Was noch nicht öffentlich ist
- Wie viele der 123 bedingten Papiere ein Dossier einreichten, wie viele anerkannt wurden und wie viele zurückgezogen wurden.
- Wie viele Position Papers der Track am 24. September angenommen hat.
- Welche Fenstereinstellung und Wertdefinition die Schwellen in Tabelle 5 verwendeten.
- Ob abgelehnte Autoren ihre eigenen Werte und die Fenstereinteilung ihres Textes zu sehen bekamen.
- Eine Kalibrierung von v3.3.2 an formaler akademischer Prosa nicht-muttersprachlicher Autoren, von Pangram oder sonst jemandem.
Wir aktualisieren diese Seite, falls die Chairs etwas davon veröffentlichen. Wenn du betroffen bist und Primärunterlagen teilen möchtest, etwa den Wortlaut der Benachrichtigung oder ein Dossier-Ergebnis, erreichst du uns unter [email protected]. Wir veröffentlichen nichts, was wir nicht überprüfen können.
8. Wenn du betroffen bist oder im nächsten Zyklus einreichst
Die Ablehnung wird als normale Desk Rejection beschrieben. Der Beitrag der Chairs verwendet die Formulierung „a standard desk-rejection“[1] und beschreibt sie nicht als Feststellung von Fehlverhalten. Sobald das Papier bei NeurIPS nicht mehr begutachtet wird, gelten die üblichen Regeln für eine Einreichung anderswo. Prüfe die Regeln der neuen Konferenz zu Doppeleinreichungen und KI-Nutzung.
Erkläre konkret. Die 22er-Stufe umfasste Autoren, die keine KI-Nutzung erklärten, und Autoren, die gar nichts erklärten. Eine leere Erklärung wurde wie eine Verneinung behandelt.
Führe einen Versionsverlauf. Das Dossier, das die Chairs verlangten, bestand aus einem Checkpoint vor der KI-Nutzung, einem danach, dem finalen Papier und einer Analyse, dass die KI-Bearbeitungen keine neue Substanz hinzugefügt haben[1]. Sie schrieben: „Wir erwarten, dass diese Art von Prüfpfad in künftigen Jahren zum Standard wird.“ Overleaf-Verlauf, Git-Commits oder der Versionsverlauf von Google Docs erzeugen ihn nebenbei. Im Nachhinein ist er kaum zu rekonstruieren.
Kenne die Belege zu deinen Werkzeugen. Im einzigen kontrollierten Test, den wir gefunden haben, führte eine vollständige Grammarly-Korrektur zu keinem „KI“-Urteil von Pangram. Maschinelle Übersetzung eines ganzen Gutachtens führte in 1,1–4,5% der Fälle dazu[5]. Beides sind kleine Tests an Texten von Gutachtenlänge, nicht an Papieren.
Achte auf Alternativen zu Detektoren. Ein Vorschlag, greCAPTCHA (Payan, Gyevnár, Kasirzadeh & Shah, 17. September), prüft, ob die genannten Autoren ihr eigenes Papier verstehen, statt die Prosa zu bewerten. Der Prototyp erreichte mit 31 Forschenden eine AUC von 0,90 bei der Vorhersage tatsächlicher Autorschaft[10]. Es ist ein kleiner Prototyp, und uns ist keine Konferenz bekannt, die ihn einsetzt.
9. Was Zitationsprüfung leisten kann und was nicht
StrictCite erkennt keine KI-Prosa, und nichts auf dieser Seite ist ein Argument für unser Produkt statt Pangram. Die beiden beantworten verschiedene Fragen. Pangram schätzt, wer einen Satz geschrieben hat, und wie die Abschnitte 4 und 5 zeigen, verorten selbst die Benchmarks des Herstellers die Unsicherheit in der polierten Mitte. Eine Referenz führt entweder zu einem echten Eintrag in Crossref, OpenAlex oder DBLP oder nicht, und die Antwort kannst du selbst prüfen. Das ist der andere Desk-Rejection-Mechanismus der NeurIPS in diesem Zyklus[12], und er ist der, den du vor der Einreichung vollständig selbst prüfen kannst. Prüfe eine Bibliografie kostenlos auf strictcite.com.